World UBE Society Workshop 2026 · Session 3. WUBE think tank
2026. 11. 14 (토) 16:55–17:03 · Conrad Seoul, Studio 8–10 (6F)
AI, 어디서부터
시작할까요?
Woon Tak Yuh, M.D.
Spine Center, Chamjoeun General Hospital, Korea
Conflict of Interest
연구 지원
SurgiCutAI — 모두의 창업 2기 funding
공동 연구
박만규 · 이상우 (부산 휴병원), 고용산 (경북대병원)
환자 정보
모든 수술 영상과 해설은 비식별화하여 처리
현기증 나는 AI 격차
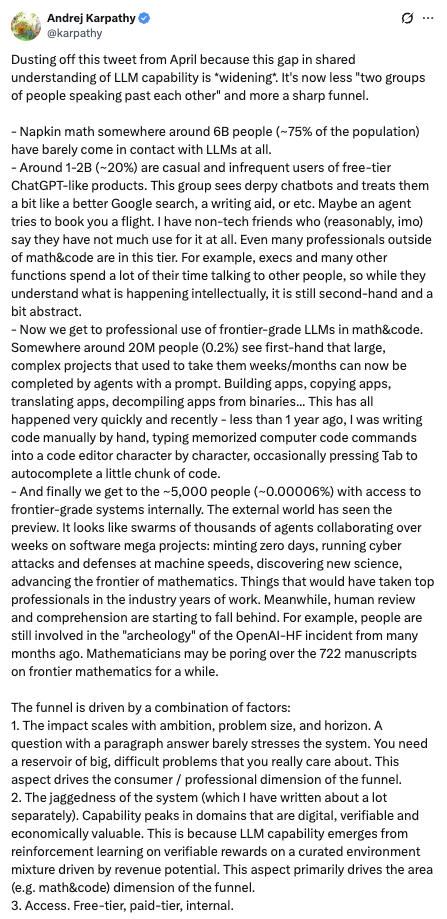
가파른 깔때기 — by Andrej Karpathy
A. Karpathy, X post, 2026-10-12 · 숫자는 원문의 어림셈
Keywords of AI's Evolution
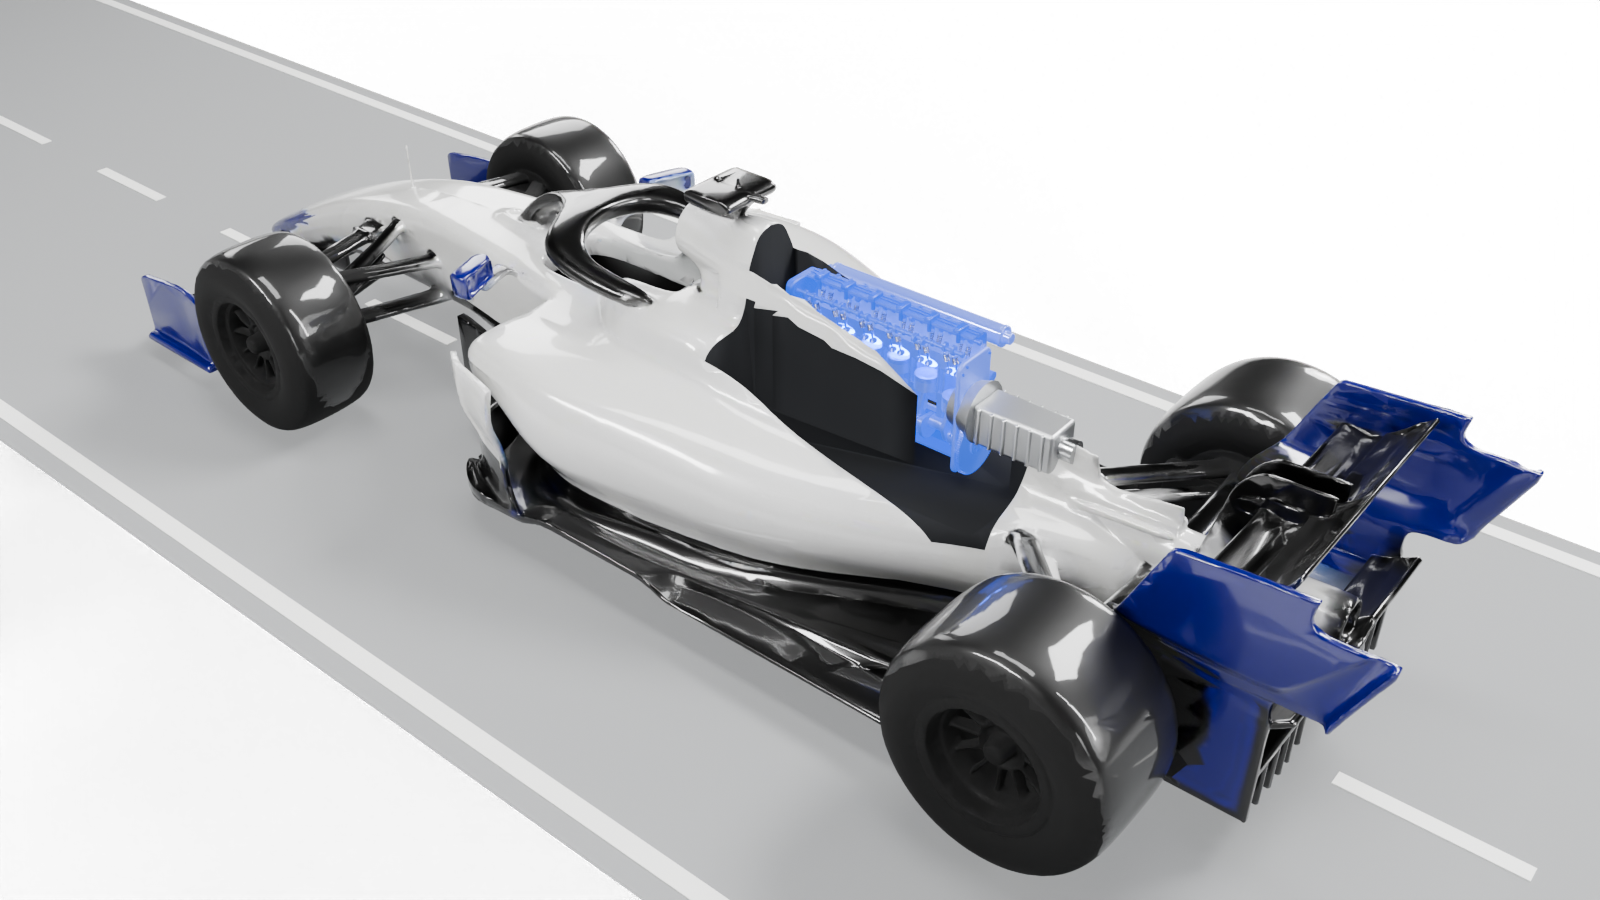
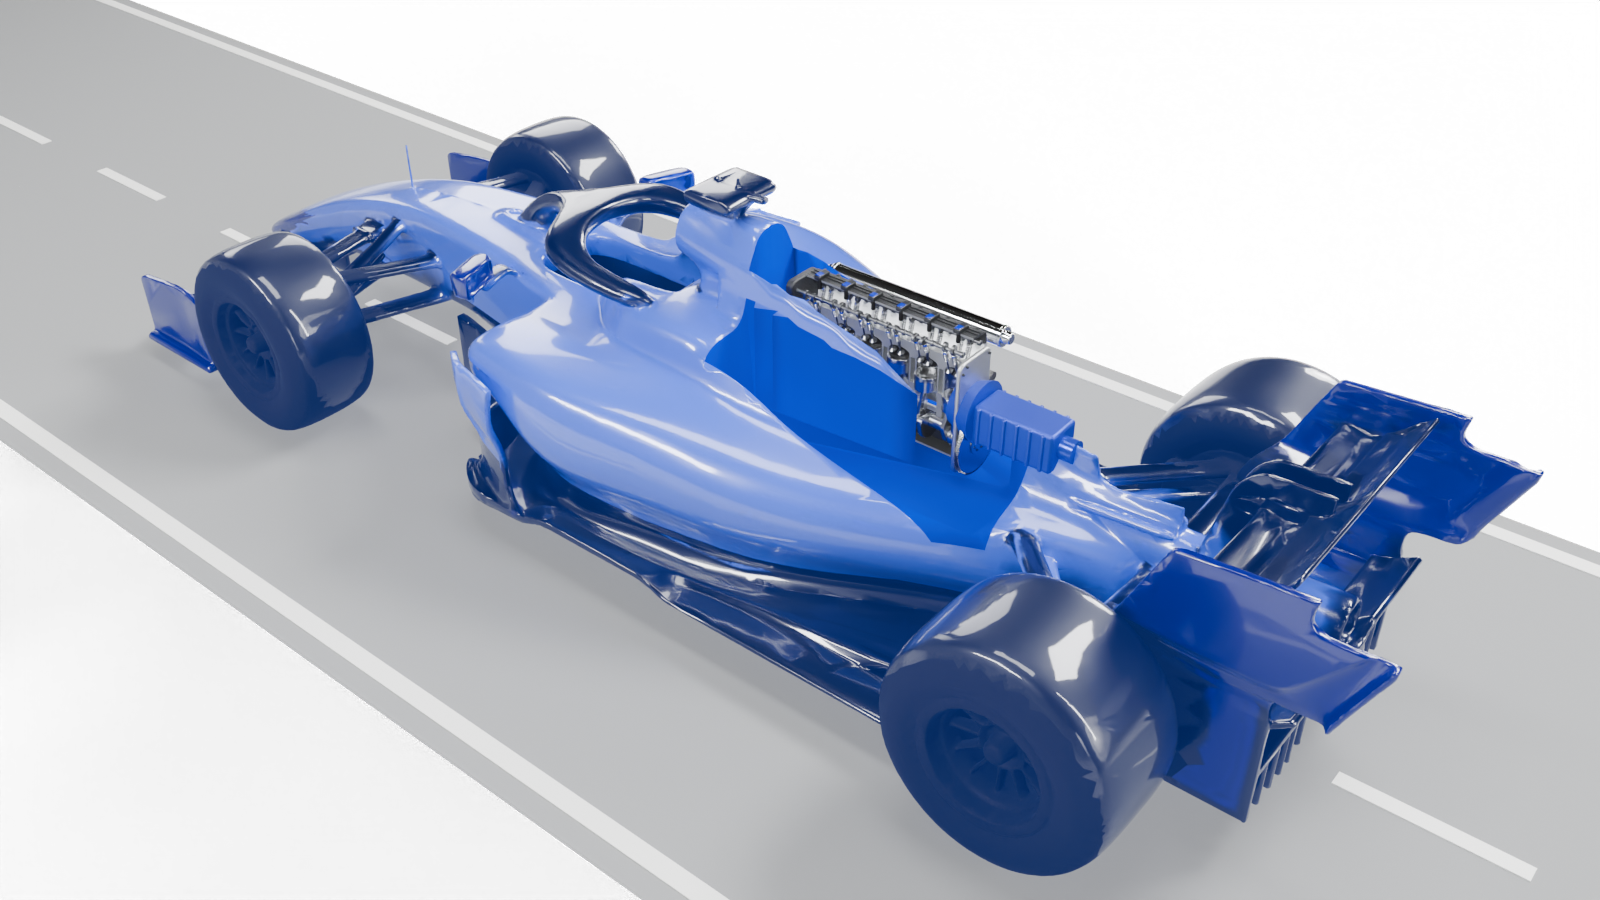
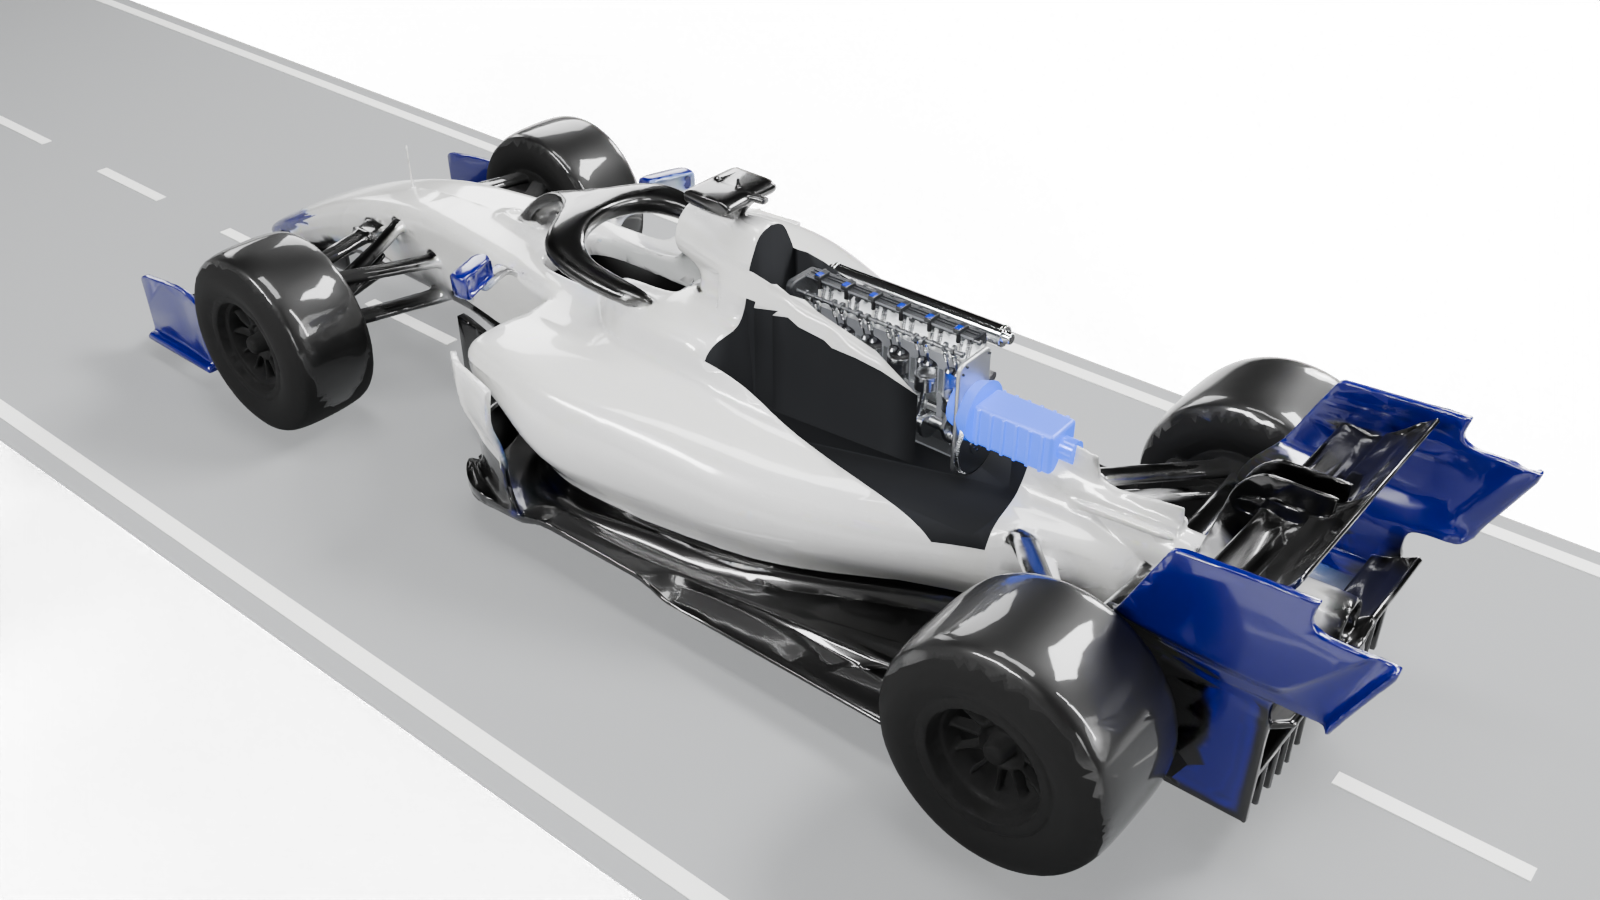
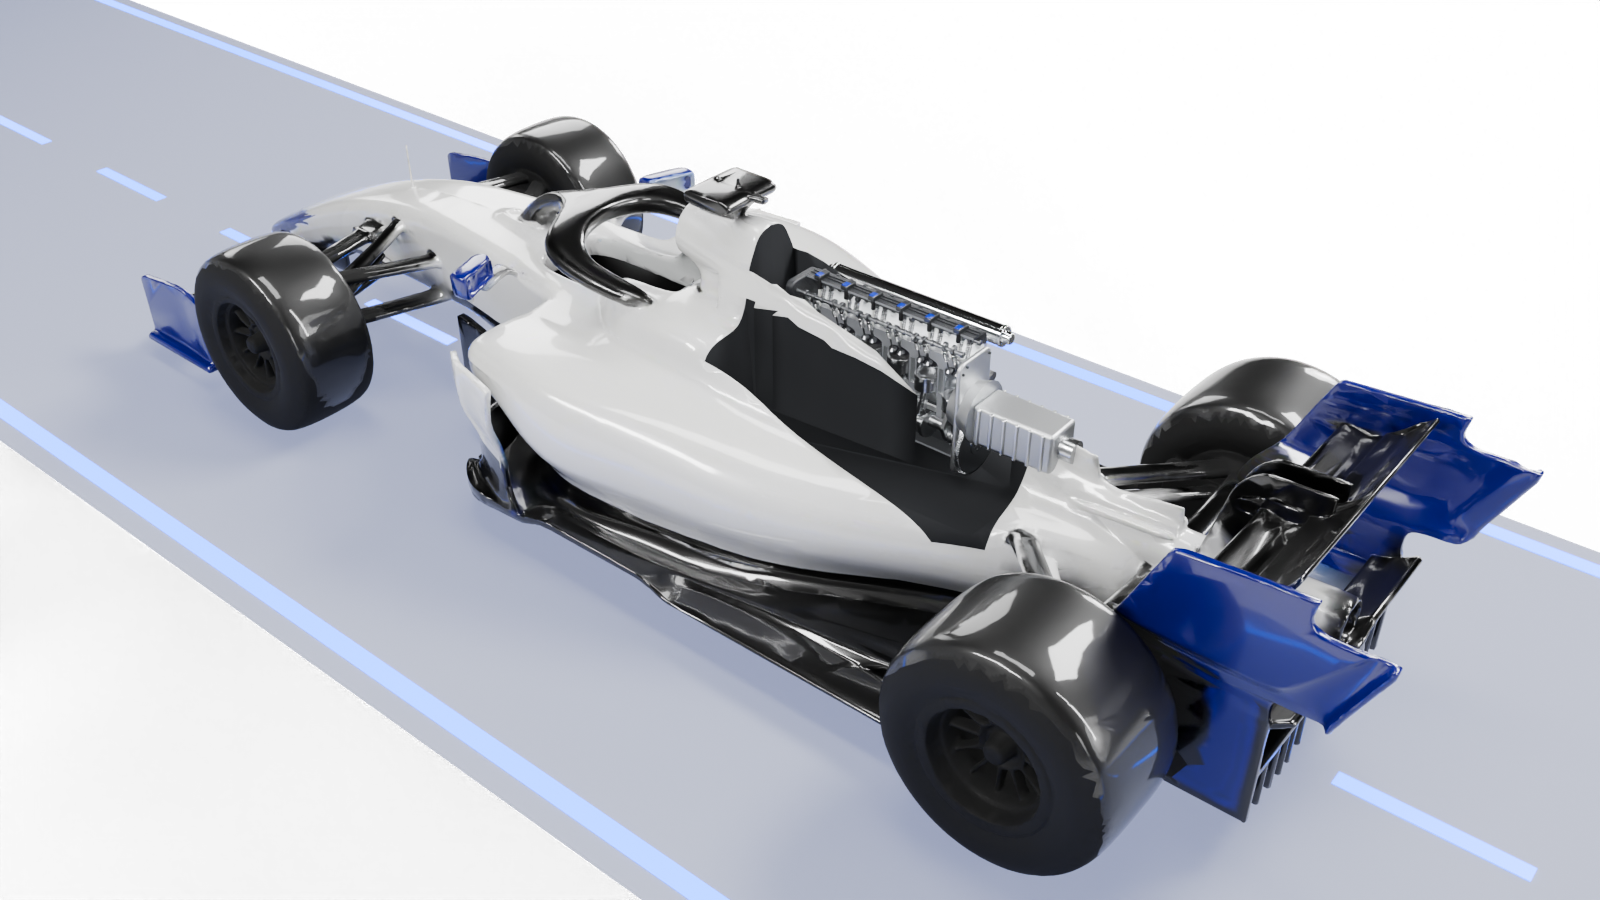
The Anatomy of an AI System
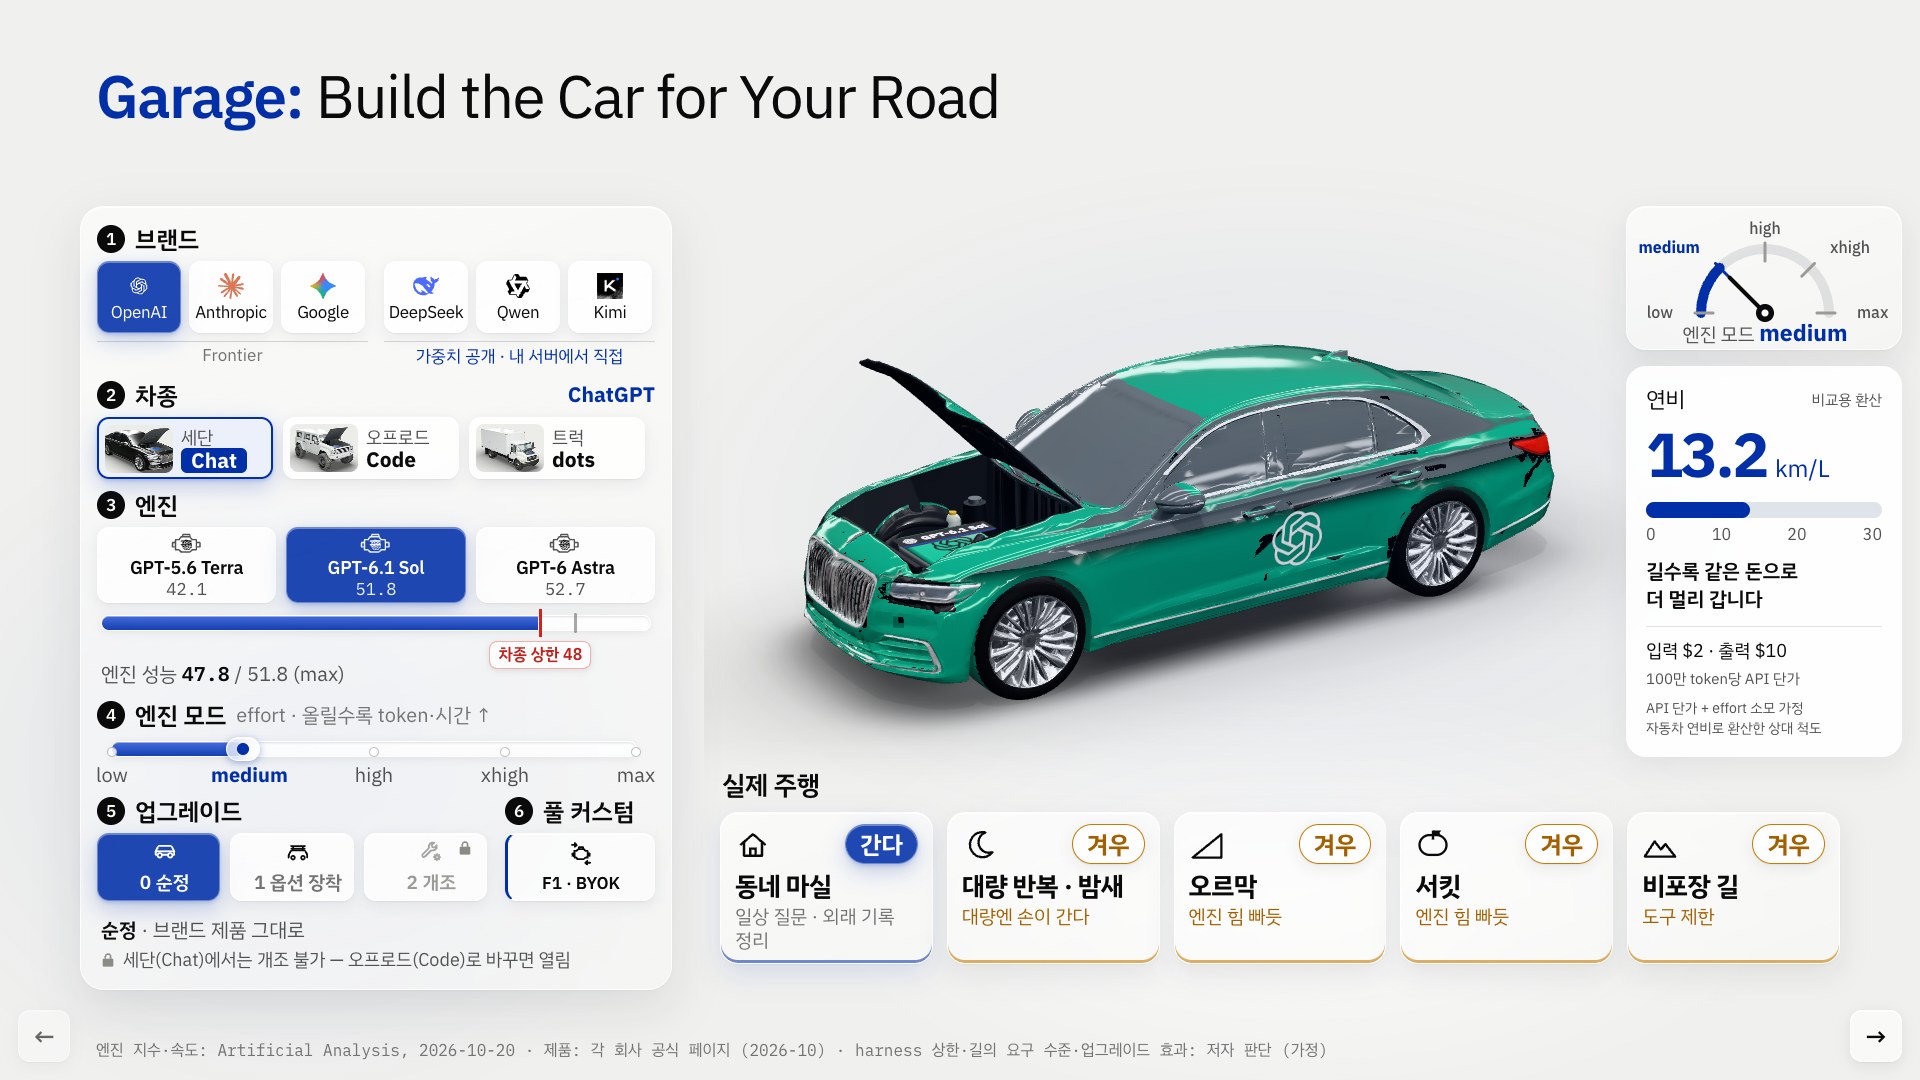
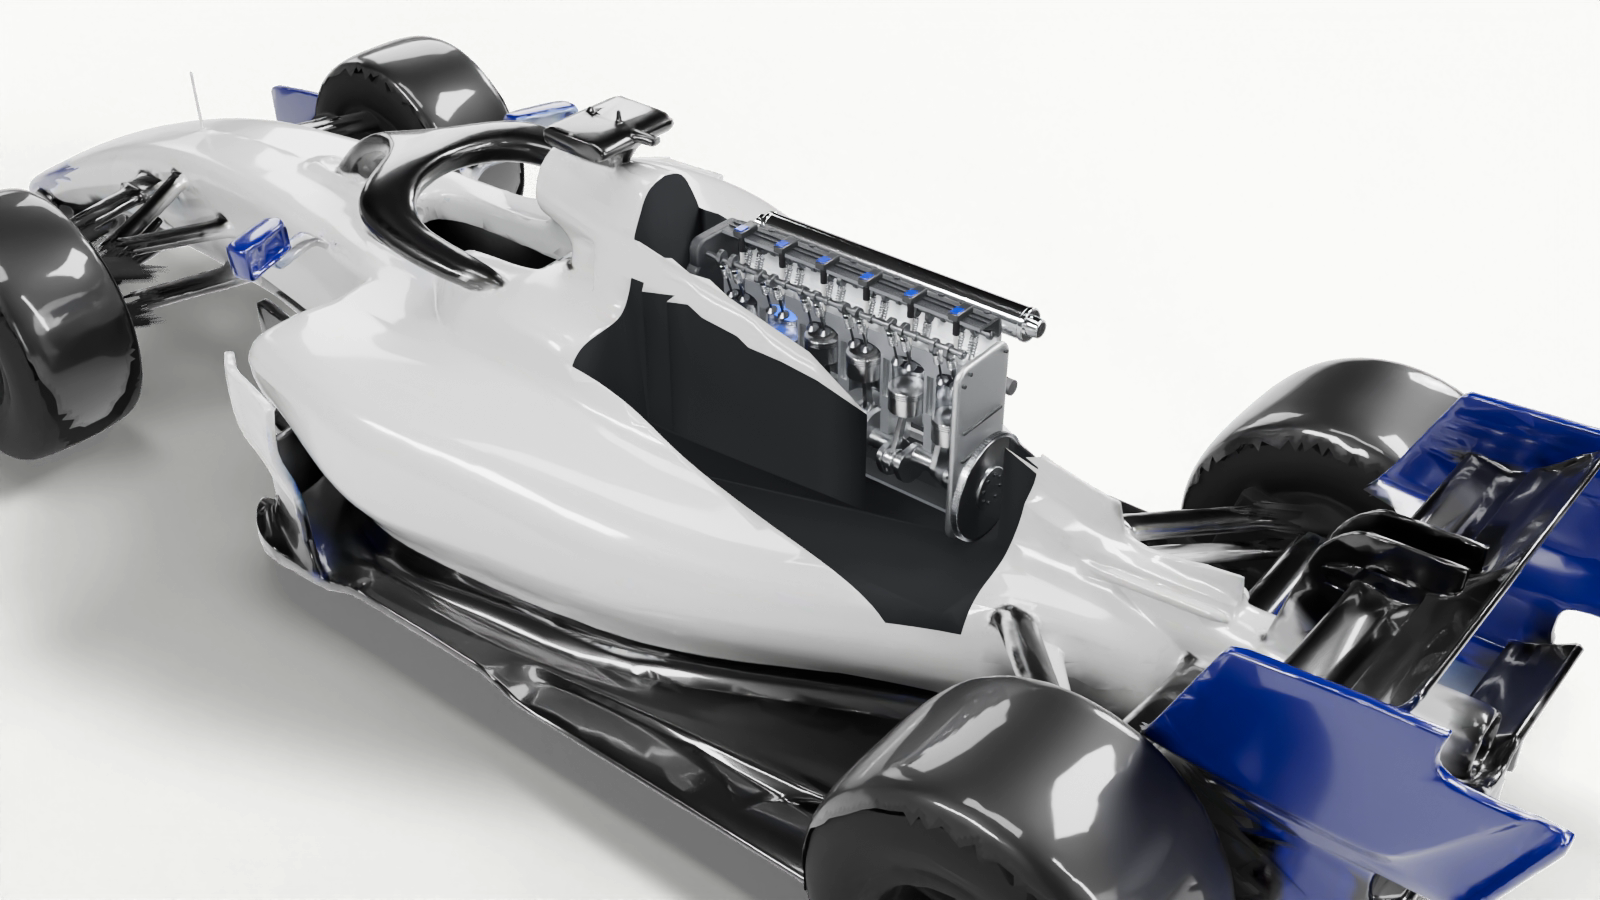
harness = 엔진을 뺀 차 전부
몸체 · 공기역학 · 서스펜션 · 바퀴
타이어 · 변속기
엔진 모드 = effort
Eco · Normal · Max Power
올리면 힘은 세지고, token과 시간은 더 든다
고르는 기준: 성능 · 비용 · 시간
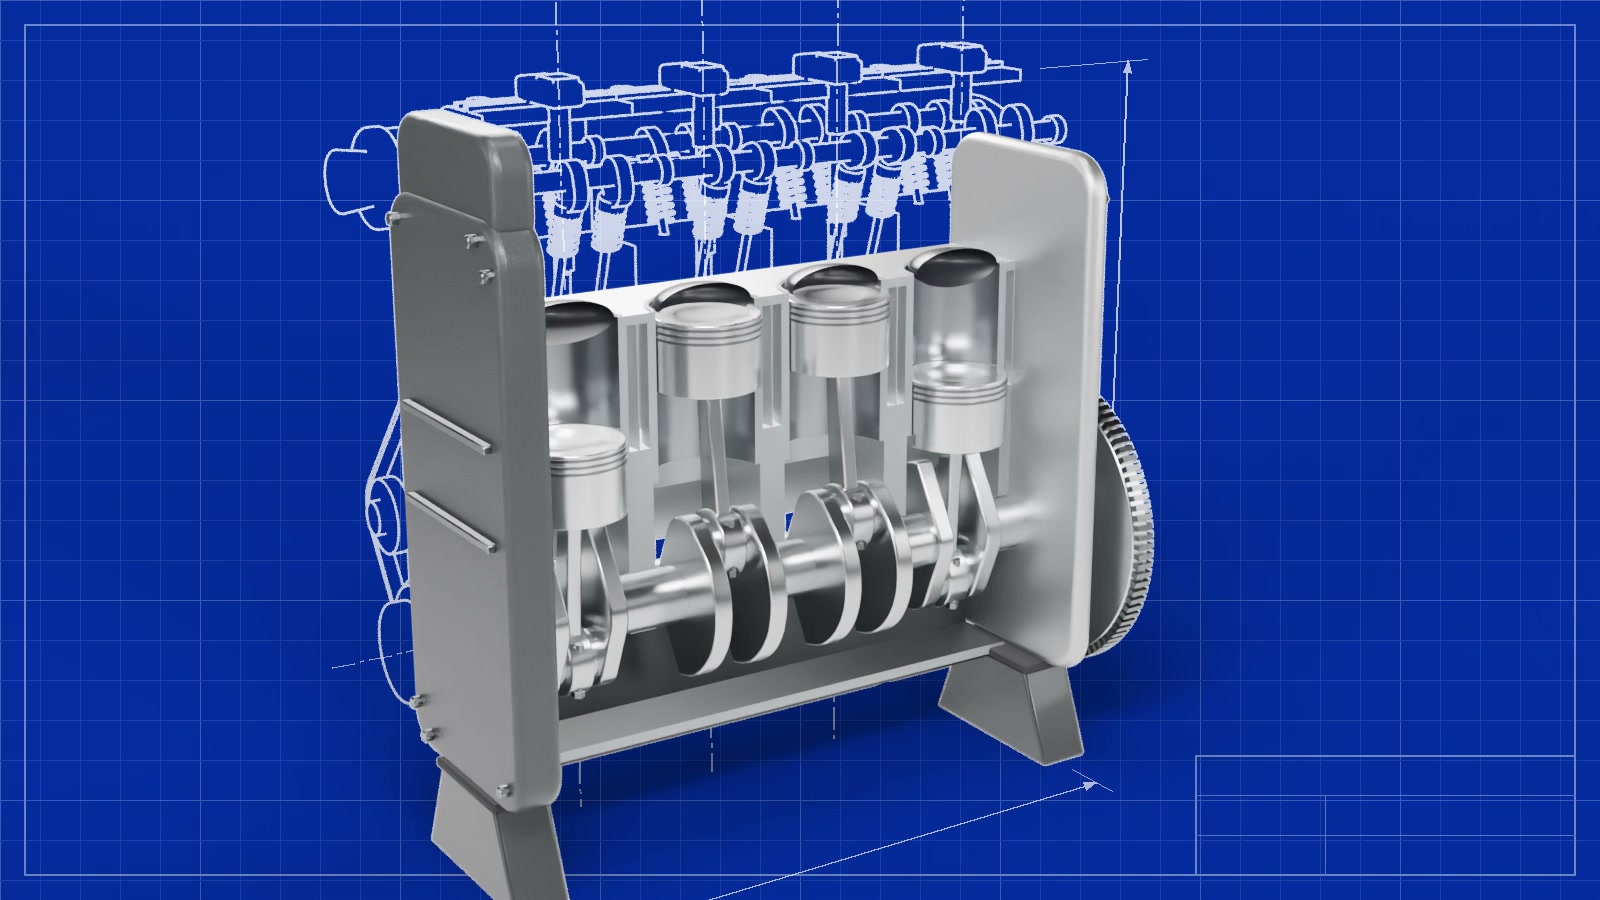
LLM: The Engine
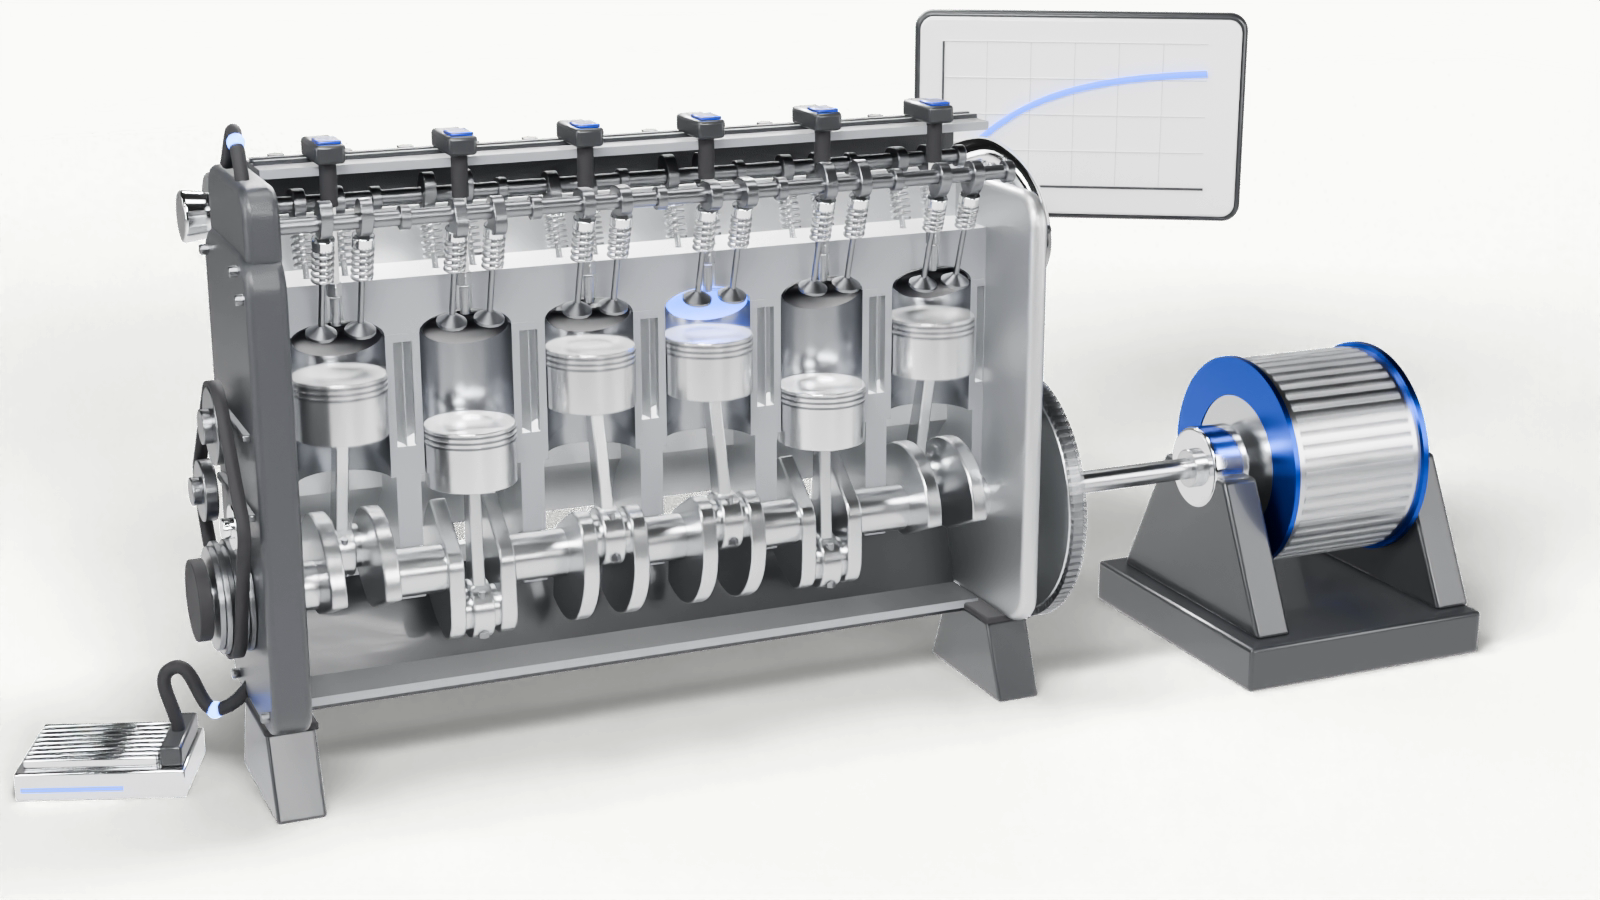
엔진 한 사이클 · token → 생성
①token = 연료글자 조각 단위 · 많이 넣을수록 연료(돈·사용량)가 든다
②Transformer = 실린더 안의 처리들어온 token들의 관계를 따져 다음 token을 계산한다
③생성 = 한 사이클의 결과한 번 돌 때마다 token 하나 · 반복하면 문장 → Inference
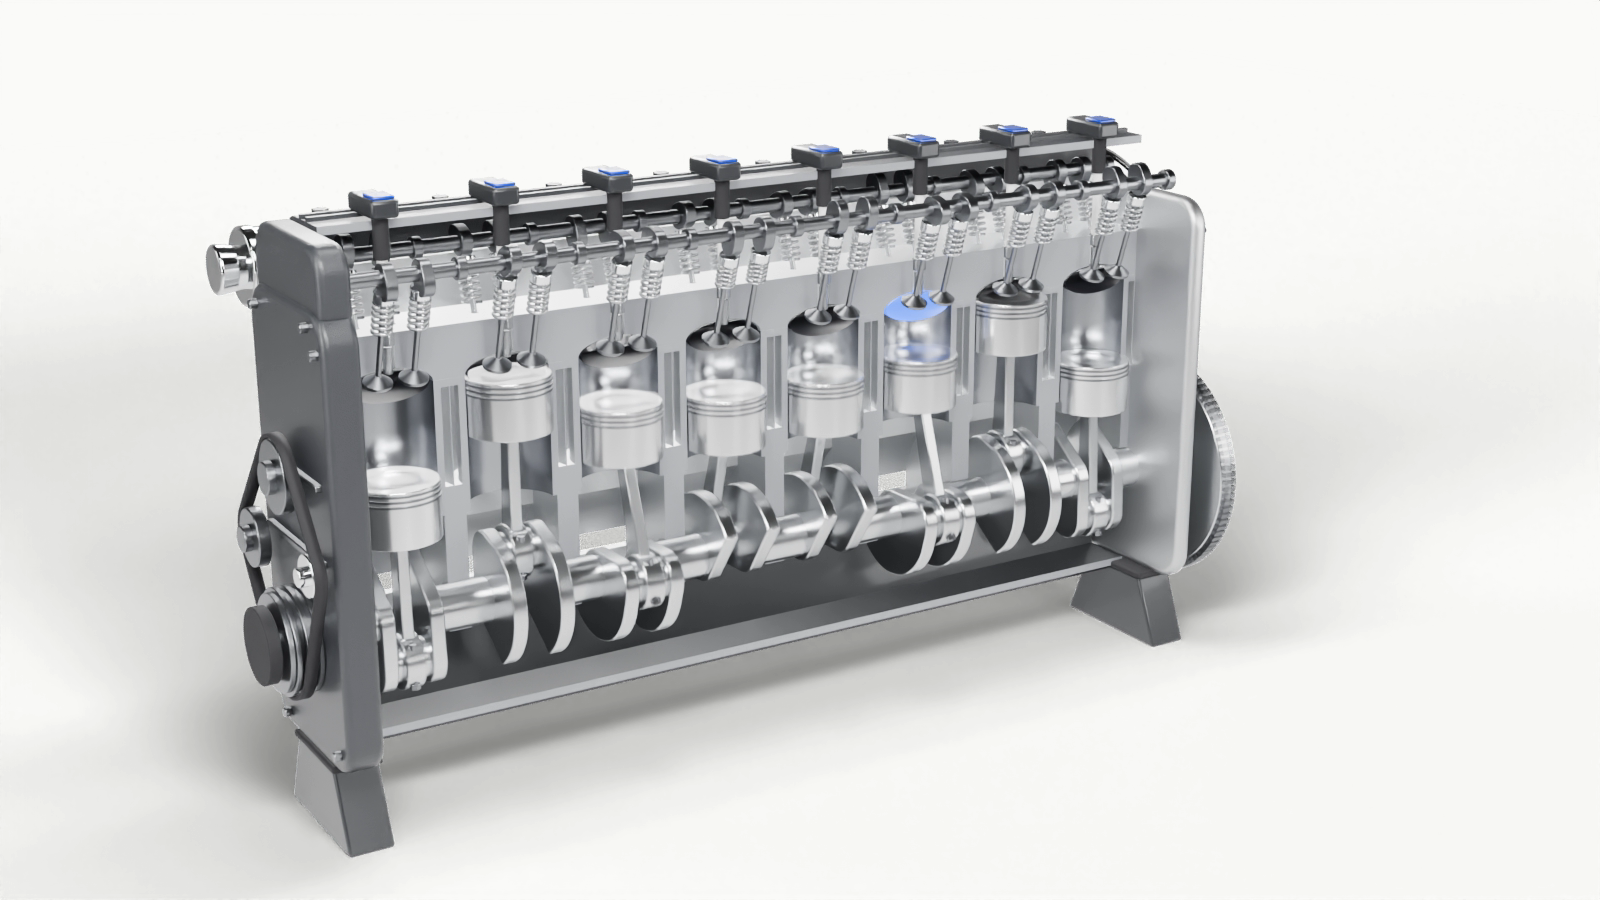
효율 · MoE (Mixture of Experts) 2024년~
Dense 6개 모두
MoE 6개 중 2개
전부 vs 필요한 전문가만
MoE = 전문가 혼합
모든 실린더를 켜지 않고, 질문에 맞는 전문가 몇 개만 켠다
예: DeepSeek-V3 전체 671B 중 token마다 37B
크기 = 배기량 = 파라미터 2020년대
크기만 키워 의사 시험 합격선
파라미터 = 학습으로 얻은 조절 값의 개수 · 많을수록 큰 엔진
같은 모델(Flan-PaLM)을 크기만 바꿔 MedQA(USMLE형) 정답률
Singhal K, et al. Nature 2023 (arXiv:2212.13138, Table 5) · 합격선 ≈60%: Kung TH, et al. PLOS Digit Health 2023
Pre-training: Engine Design
모델 뼈대 만들기
~2023
웹 글
공개 웹을 거의 다 학습 · 데이터도 같이 키움 (Chinchilla)
2024
바닥
“Pre-training as we know it will end” — Sutskever 2024
2024–25
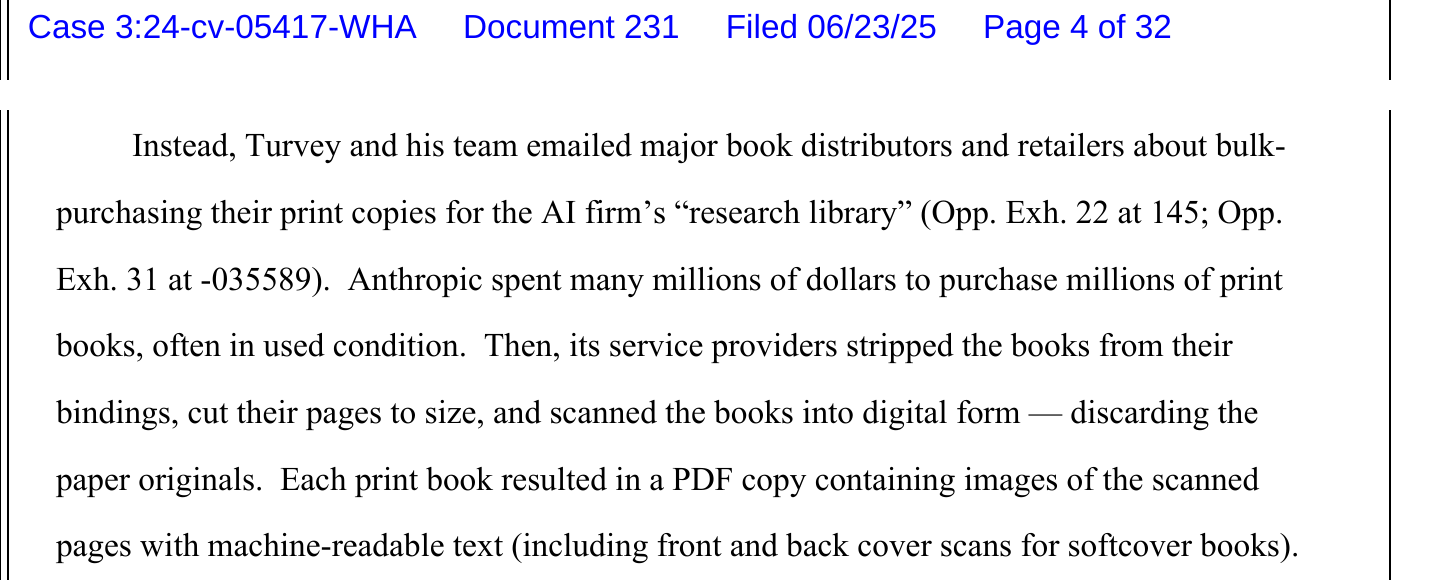
종이책
중고 종이책 수백만 권 → 제본 뜯고 스캔 → 종이 폐기
2025
전문가 자료
의사·변호사가 문제·정답을 만든다 · Mercor 100억 달러
2023–26
영상
Gemini (2023) · Kimi K3 (2026): 비디오까지
파라미터 = 배기량 · MoE는 일부만
| 연도 | 모델 | 총 | 활성 | 학습 token |
|---|
| 2019 | GPT-2 | 1.5B | 전부 | 비공개 |
| 2020 | GPT-3 | 175B | 전부 | 0.3T |
| 2022 | PaLM | 540B | 전부 | 0.78T |
| 2024 | Llama 3.1 | 405B | 전부 | 15.6T |
| 2024 | DeepSeek-V3 | 671B | 37B | 14.8T |
| 2025 | Kimi K2 | 1T | 32B | 15.5T |
| 2026 | DeepSeek-V4-Pro | 1.6T | 49B | 32T+ |
| 2026 | Kimi K3 | 2.8T | 104B | 비공개 |
| 2023 | GPT-4 | 총 약 1.8T (추정·보도) 나머지 비공개 |
수백만 권을 사서 → 제본을 뜯어 스캔하고 → 종이는 버렸다

미 연방법원 판결문 (Bartz v. Anthropic, 2025-06-23)
코드를 먹이면 코드 성능 최대 12배
(작은 모델, Cohere 2024)
전문가 자료 — 정답지를 만드는 산업
의사·변호사가 문제와 모범답안을 쓴다
시간 단위로 고용된다
Mercor 전문가 3만 명+ · 기업가치 100억 달러
Scale AI · Meta가 143억 달러 투자 (2025.6)
HealthBench — 의사 262명이 채점 기준 작성
의학은 만들기 어렵다
정답이 진료실 밖, 시간이 지난 뒤에 생긴다
✉Expert response request
Parkinson's disease · Rheumatoid arthritis
위협이자 기회
우리 지식이 다음 모델의 기능이 된다
키울수록 똑똑해졌다 — 그런데 여전히
지어내고, 시키는 대로 안 하고, 틀렸다
논문·모델 카드 · GPT-4: SemiAnalysis·Epoch AI 추정 · Sutskever 2024 · Bartz v. Anthropic · TechCrunch · Gemini · Kimi K3 · Aryabumi
Post-training: Engine Tuning
모델 튜닝하기 — 누가 채점하나
SFTRL→RLHF→RLVR 채점 → 결과
키우기만으론 부족RL: 점수로 배운다RLHF: 사람이 채점 → 그럴듯함RLVR: 정답지로 채점 → 진짜 맞은 답
왜 튜닝?Post-training이 필요한 이유
모델만 키운다고 되는 게 아니구나
100배 작은 튜닝 모델의 답이 더 선호됐다
InstructGPT, Ouyang 2022
엔진도 세기만 하면 될 줄 알았는데,
차에 쓸 수 있게 다듬는 튜닝이
차를 만들더라
전문가가 만든 정답지로 튜닝한다
튜닝 1단계 · SFT Supervised Fine-Tuning, 지도 학습
사람이 쓴 모범 답안을 보여 주고 그대로 따라 하게 한다 — 질문하면 대답하는 ‘말투’가 여기서 생긴다
그다음 단계: 모범 답안 없이, 점수로 배운다 (RL) →
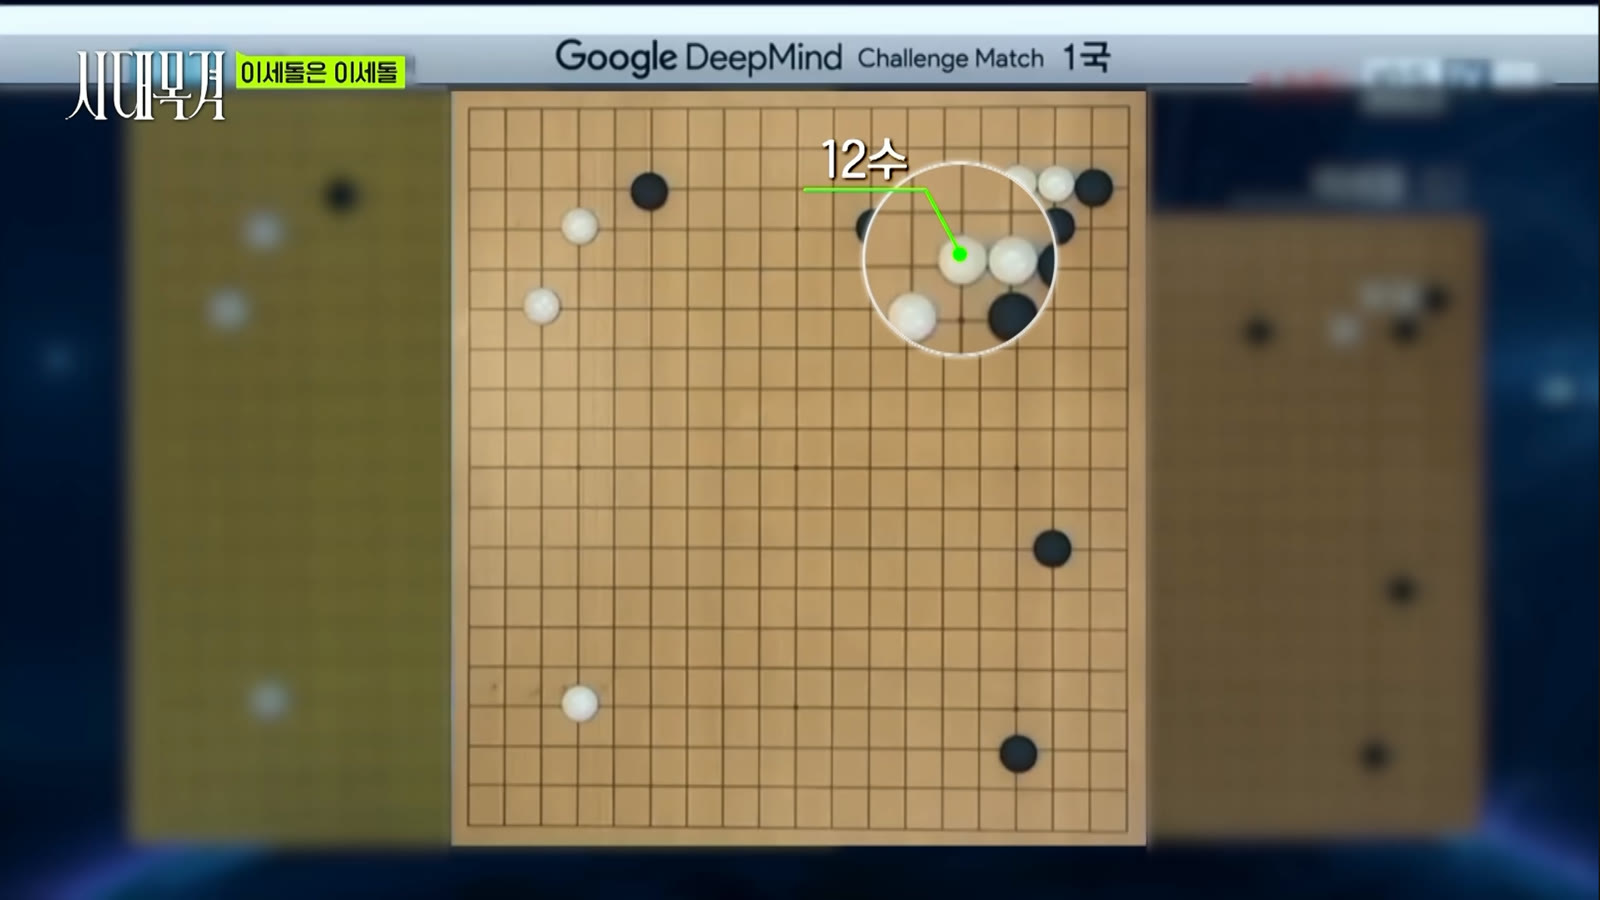
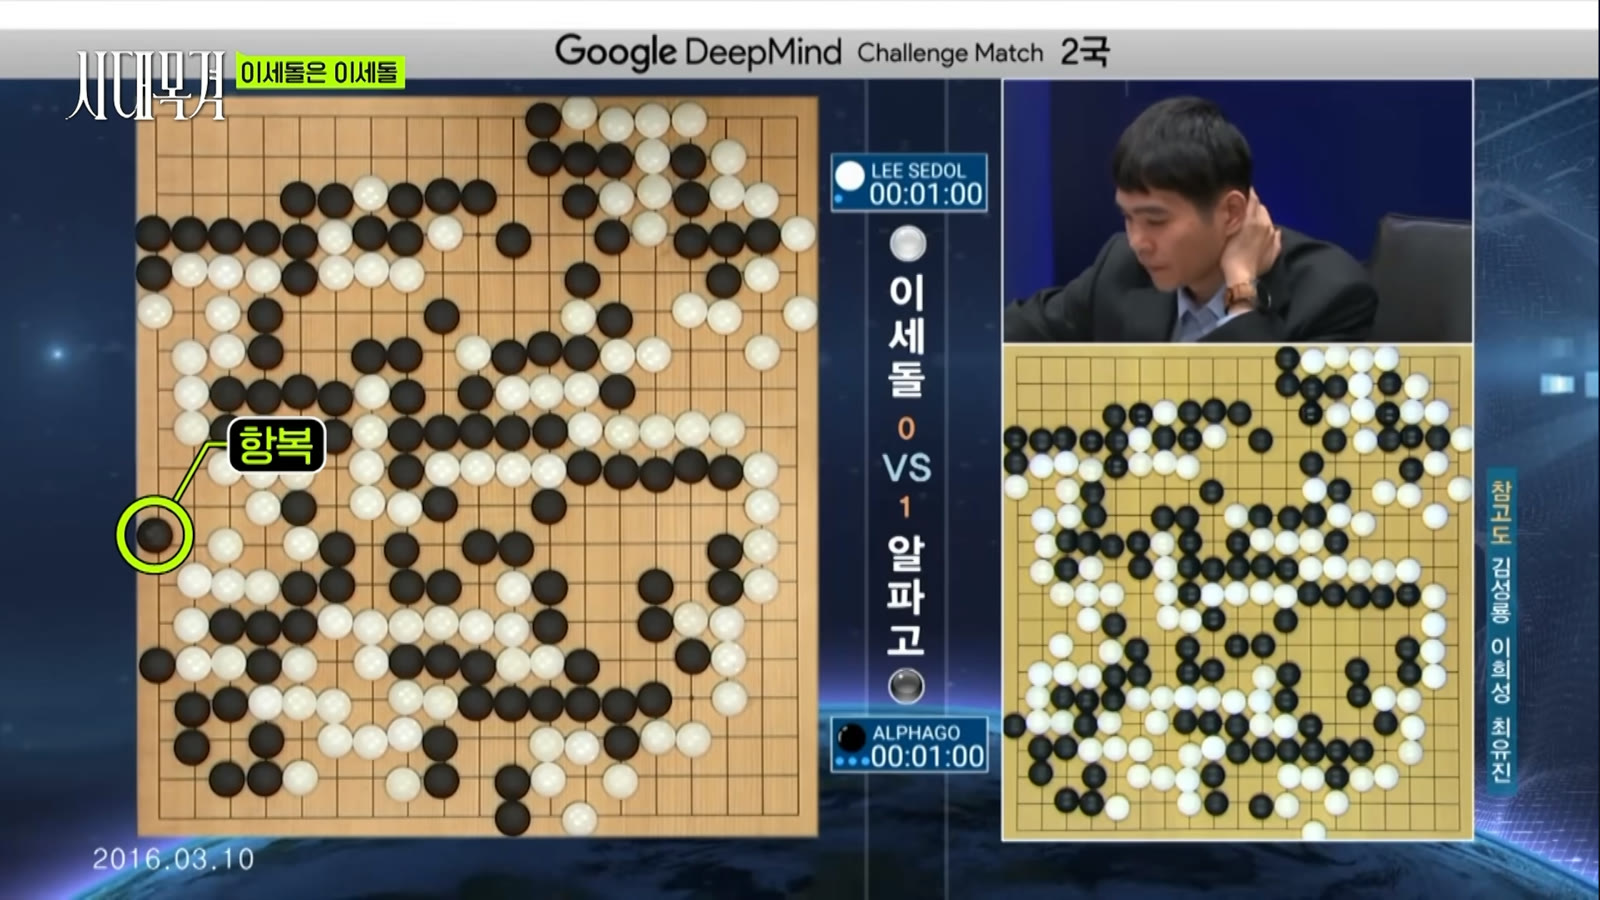
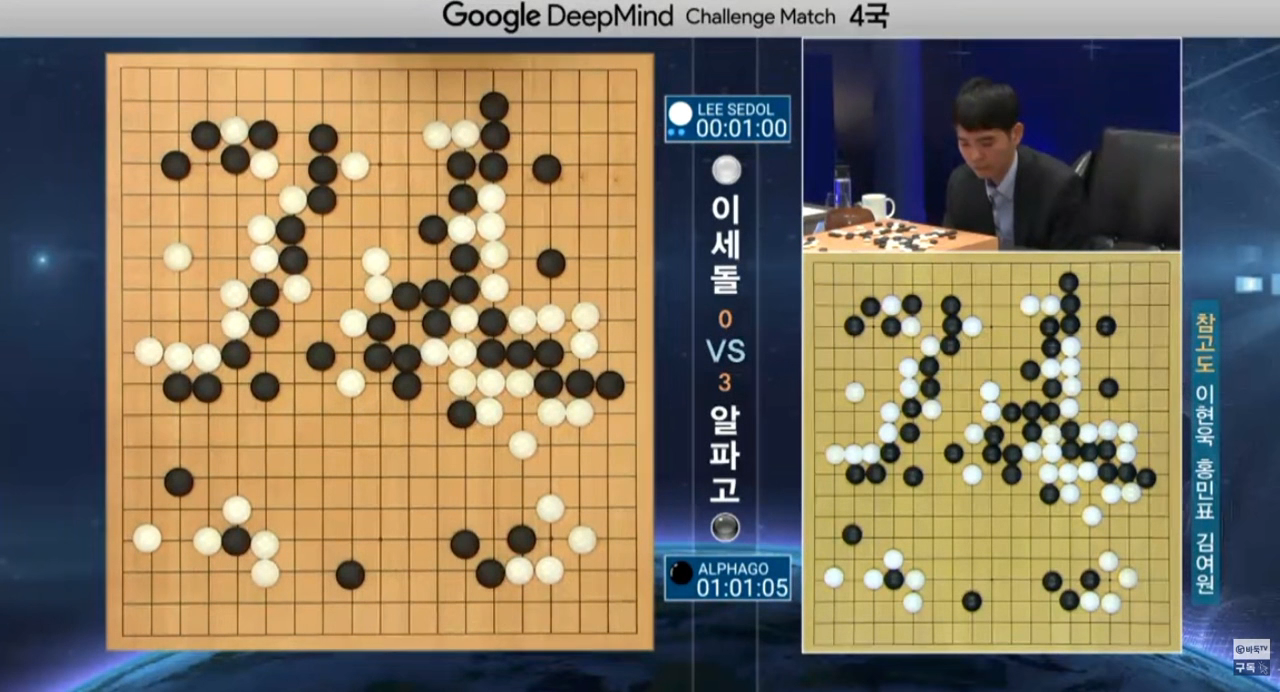
AlphaGo vs 이세돌 9단 · 2016년 3월 서울 · 4 : 11국 12수2국 · 돌을 던지다2연패 뒤4국 · 인간의 1승
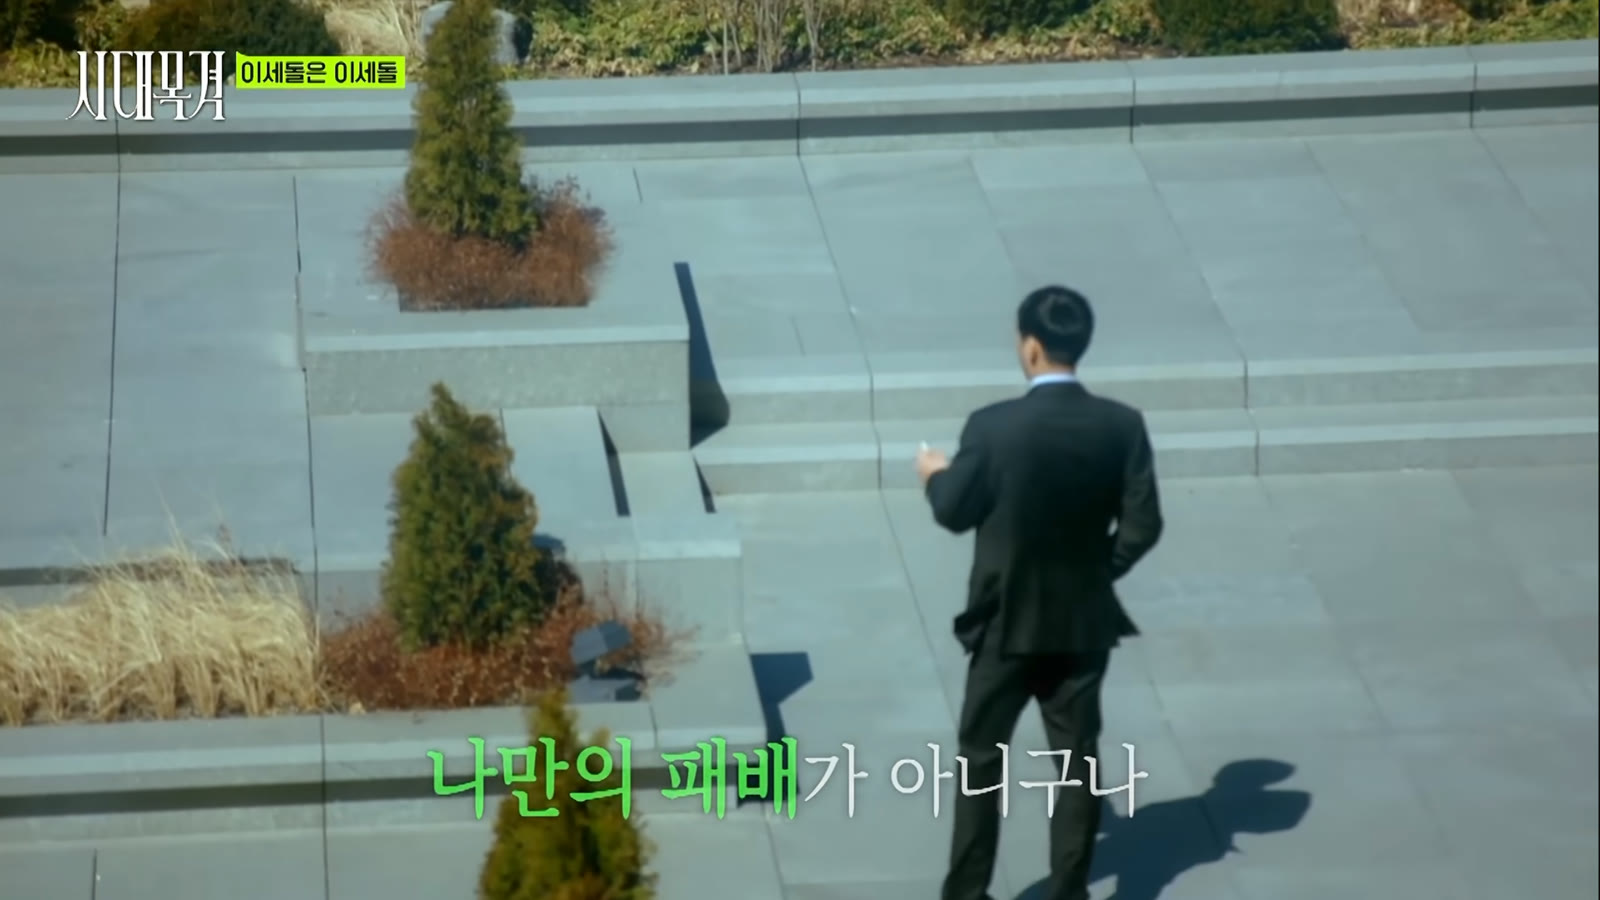
이세돌 9단 인터뷰
1국“12번째 수부터 ‘잘 두는구나’ 생각은 했습니다”
2국“2국은 정말 충격적이었어요”
“왜 졌는지 정확하게 몰라요”
그리고“나만의 패배가 아니구나”
알파고는 매 수 이길 확률(승률)이 가장 높은 수를 둔다
사람은 감각으로, 알파고는 결과(승패)로 배웠다
RLReinforcement Learning · 강화학습
해 보고, 결과를 보고 →
보상으로 배운다
보상 +원하는 결과가 나오면 그 행동을 더 하게
보상 없음아니면 점점 덜 하게
정답(모범 답안)은 가르쳐 주지 않는다 — 결과에 대한 보상만 준다
바둑은 이기면 보상, 지면 없음 — 분명하다
대화는, 진료는 누가 보상을 매기나?
ChatGPT GPT-3.5 기반 · 2022년 11월
RLHF
Reinforcement Learning from Human Feedback
사람 피드백으로 하는 강화학습
지금 우리가 아는 챗봇의 시작
사람이 좋아할 말을 하도록
‘사회화된’ 대화형 모델
잃은 것 — 좋아할 말 ≠ 맞는 말
선호를 강화하지, 사실을 강화하지 않는다
긴 답 선호 (Singhal 2023) · 아첨 (Sharma 2023)
‘모르겠습니다’보다 자신 있게 찍은 전공의가 더 좋은 평가를 받는 것과 같다
의료 현장 (원인 미확정): “Are you sure?” 한마디에 진단 51.8% → 42.2% · 지어낸 참고문헌 26.4%
사람은 ‘맞았나’가 아니라 ‘그럴듯한가’를 채점했다
→ 그래서 AI는 그럴듯하게 지어내는 법을 배웠다
그래서 필요했던 것: 사람 대신 정답지로 채점하기
RLVRReinforcement Learning with Verifiable Rewards
(검증 가능한 보상)
RLHF사람이 고른다 → 그럴듯한 답에 보상
RLVR정답지로 채점 → 진짜 맞은 답에만 보상
전공의로 치면
0점감으로 바로, 그럴듯하게 답한 전공의 — 틀렸다
100점오래 따져 보고 답한 전공의 — 맞혔다
정답지로 채점 → 맞히면 보상
길이가 아니라 정답 여부가 보상을 정한다 → 그러면 무슨 일이?
Yuh WT, et al. JKNS 2026 · Ouyang 2022 · DeepMind · Singhal 2023 · Sharma 2023 · Samsel 2026 · Jain 2026 · Guo 2025 (CC BY) · Kalai 2025 · 영상: EBS 〈시대목격〉
RLVR: How It Became the Standard
1씨앗 2022–23
2022.1
Chain-of-Thought Google
'단계별로 생각해 보라' — 질문만 바꿔도 수학 ↑
2022.3
STaR Stanford
스스로 푼 풀이 중 정답 맞은 것만 다시 학습
2023.5
Let's Verify Step by Step OpenAI
풀이 단계마다 채점 (과정 보상)
2결과가 먼저 2024
2024.2
DeepSeekMath DeepSeek
강화학습 알고리즘 GRPO 등장
2024.9
o1-preview OpenAI
'오래 생각할수록 잘한다' — 방법은 비공개
2024.11
Tülu 3 AI2 · 비영리 연구소
'RLVR'이라는 이름이 처음 붙다
3공개 → 대명사 2025
2025.1
DeepSeek-R1 오픈 웨이트
정답 채점만으로 생각이 길어졌다
'aha moment' · 방법·가중치 전부 공개
2025.1–3
재현 붐 Kimi k1.5 · Open-R1 · TinyZero
작은 모델로도 따라 된다
2025.2–4
모두 생각하는 모드 Claude · Gemini · Qwen
effort(엔진 모드)가 표준이 되다
2025.4
반론 Yue 외
'새 능력이 아니라, 있던 걸 꺼낼 뿐' — 논쟁 중
2025.9
R1, Nature 게재 Guo 외
엔진 학습 $5.6M → 추론 RL $0.29M
1/20 비용으로 생각하는 모델이 됐다
Nature 645:633–638 (2025.9.17) · open access · doi 10.1038/s41586-025-09422-z
결과는 OpenAI가 먼저 보여 주고 → 이름은 비영리 연구소가 붙이고 → DeepSeek가 전부 공개하면서 대명사가 됐다
Wei 2022 · Zelikman 2022 · Lightman 2023 · Shao 2024 · OpenAI 2024 · Lambert 2024 · Guo, Nature 2025 · DeepSeek-V3 기술보고서 2024 · Reuters 2025-09-18 · Yue 2025
RLVR: Then It Learned to Think Longer
정답에 보상 → 되짚기·검산이 발달 → 더 깊은 추론
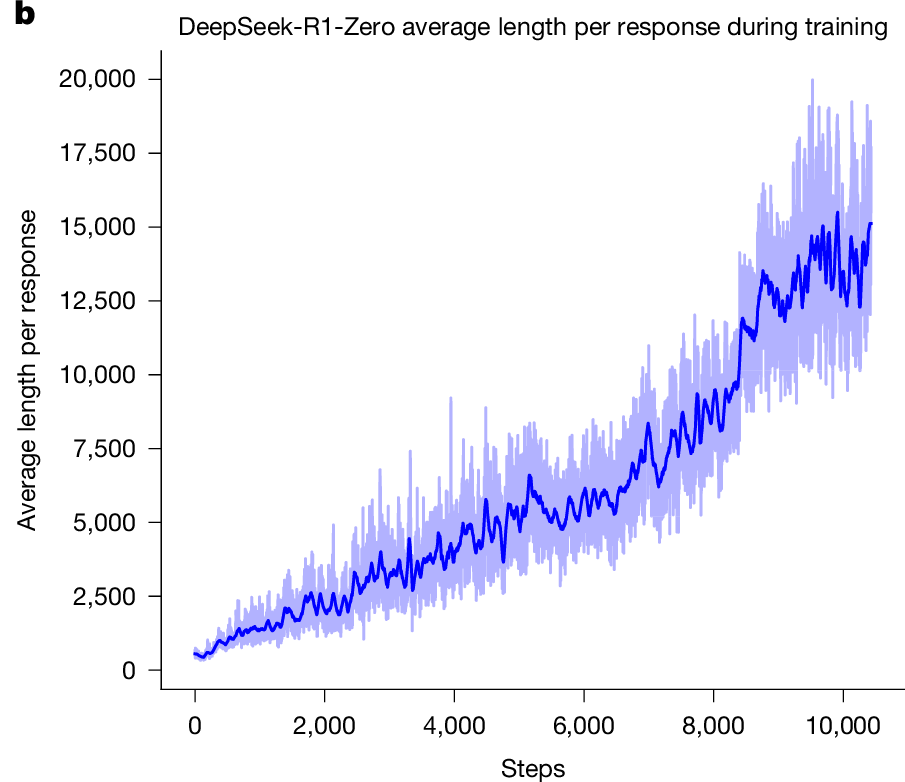
응답이 저절로 길어졌다 — ‘wait’·‘check’
되짚기와 검산이 스스로 생겼다
그래서 성능이 올랐다
AIME · DeepSeek-R1-Zero (2025.1)
15.6% → 77.9%
다른 모델: GPT-4o (2024.5) 12% → o1 (2024.9) 74%
얻은 능력: reasoning · 생각 시간을 고른다 = 엔진 모드
한계: 정답이 없으면 모를 때 찍는다
o1 16% → o3 (2025.4) 33% · OpenAI 내부 평가, Kalai 2025
정답으로 채점할 수 있다 = Verifiable Reward로 학습할 수 있다 → 수학 · 코딩이 먼저 정복됐다
수학계는 지금 충격 속 — IMO 금메달급 (2025.7) → 에르되시 난제들 → 밀레니엄 난제 Navier–Stokes 증명 주장 (2026.9, 검증 중) → 논문 722편 공개 (2026.10)
Guo 2025, Nature (CC BY) · OpenAI 2024 · Kalai 2025 · Quanta 2026.8–9 · IMO 2025 · AI Frontier EP114·118 (2차)
Harness: Everything but the Engine
말 = 모델 · 마구(馬具) = harness
말의 힘을 수레를 끄는 일로 바꾸고, 고삐로 방향을 잡는다
harness = 내가 짜는 업무 매뉴얼 — CLAUDE.md · AGENTS.md 같은 파일
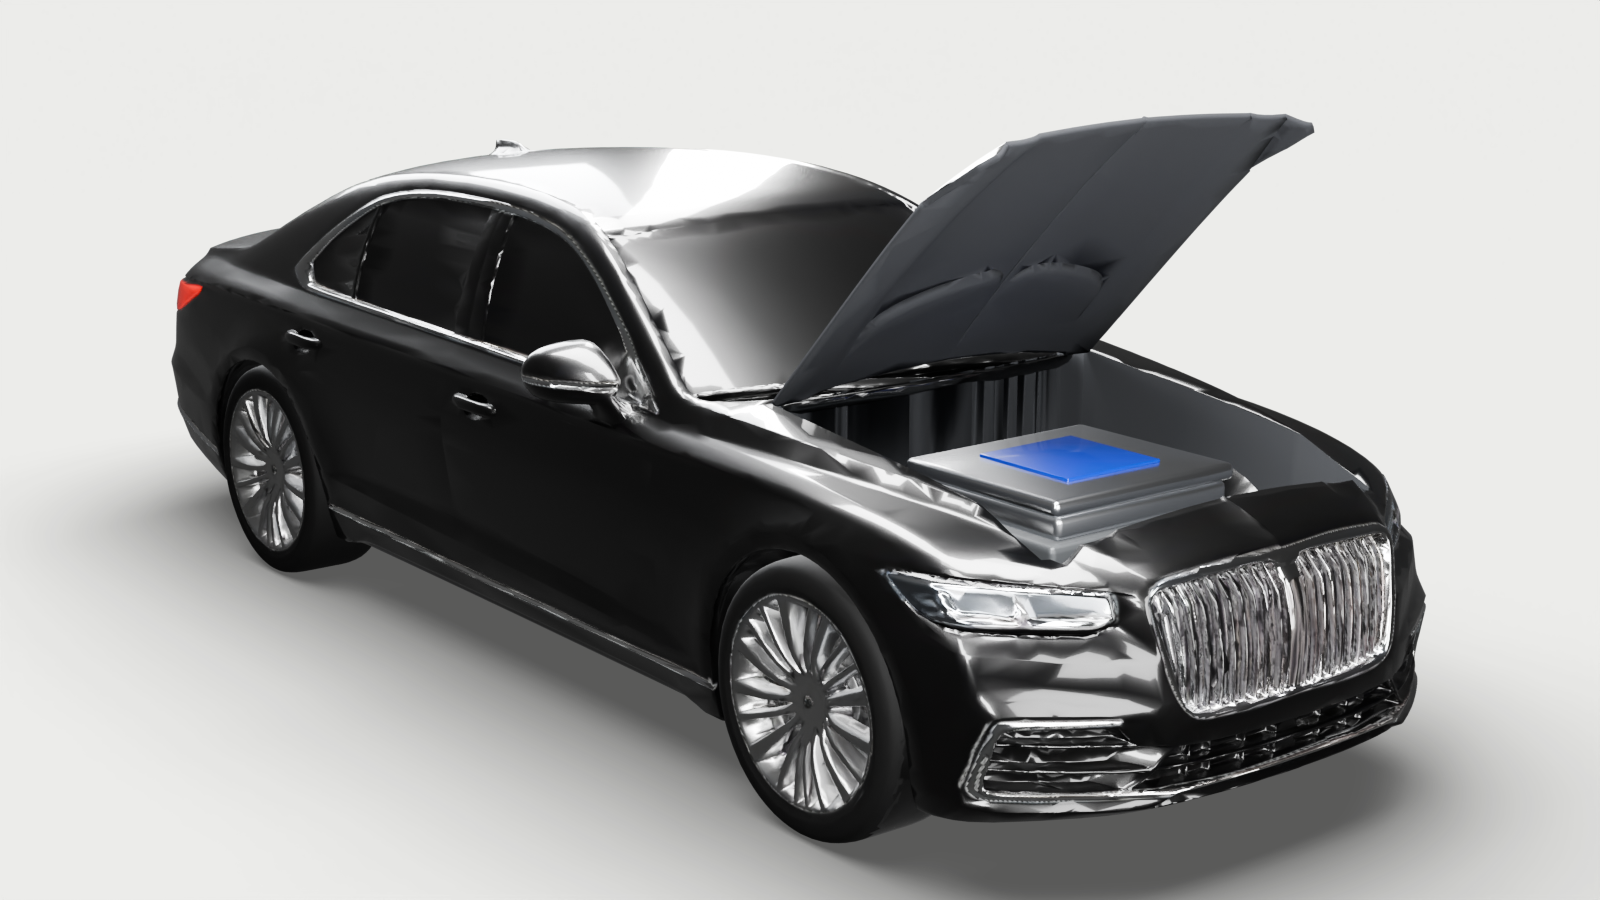
harness 거의 없이 (바닐라)
채팅 모드회사가 정한 그대로
가벼운 harness
Cowork지침 · 도구를 조금 붙인다
무거운 harness
Code매뉴얼을 세세하게 짠다
- 정해진 방식으로 한 번 답한다
- 어떻게 일할지는 손댈 수 없다
- 검증은 내가 따로 한다
- 프로젝트 지침 · 자료 폴더 지침
- 쓸 도구를 고른다 도구
- 절차는 대부분 AI에 맡긴다
- 자료는 어디서, 진실성은 어떻게 수집
- 몇 번 돌려 서로 비교 검증할지 루프
- subagent 몇 개로 나눠 협업할지 분업
같은 모델이라도 내 일에 맞춘 harness가 결과를 끌어올린다
남이 만들어 둔 harness를 가져다 쓰고, 내 일에 맞게 직접 짜기도 한다
단, 모델이 바뀌면 옛 harness가 짐이 된다 — 눈가리개를 벗긴 개량종 말은 주변을 살피며 더 잘 달린다
Who Builds the Car?
엔진 공개
엔진 설계도(가중치)까지 공개
가져다 내 서버에서 돌리고 · 내 차고에서 직접 튜닝
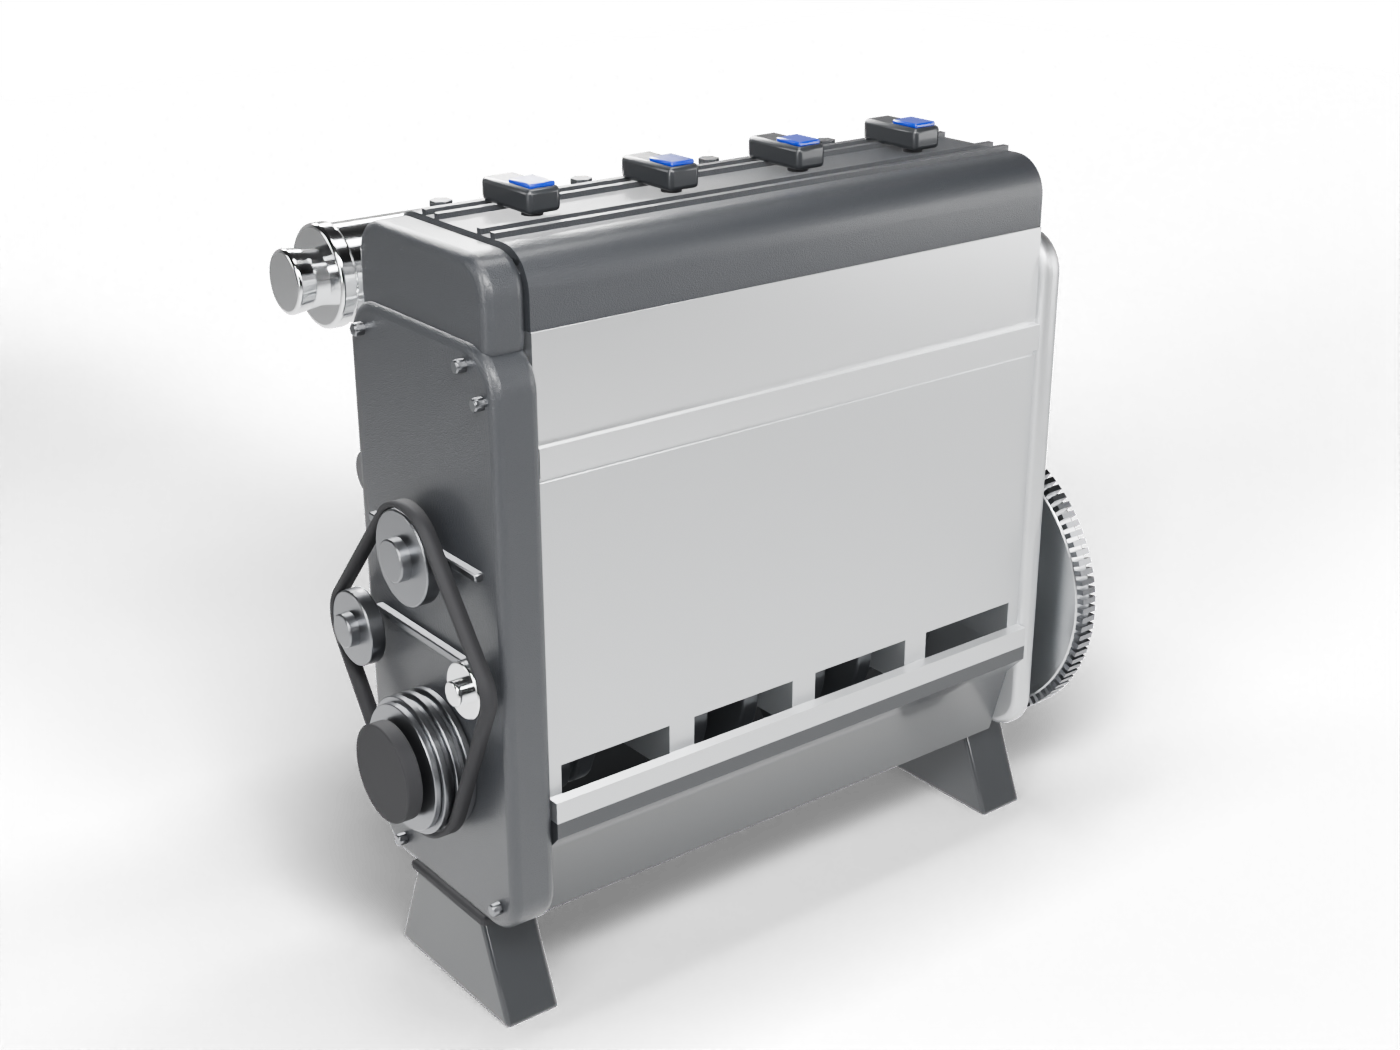
harness만
남의 엔진을 사서 끼운다
OmO
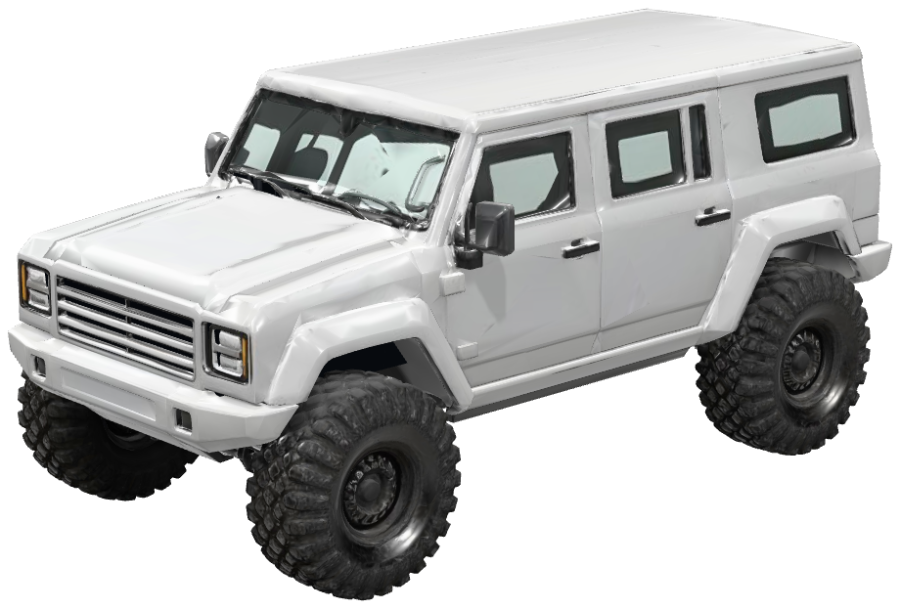
대다수 사용자: 기성 완성차를 탄다
ChatGPT · Claude 앱(채팅 모드) — 웬만한 일상의 길은 다 갈 수 있다
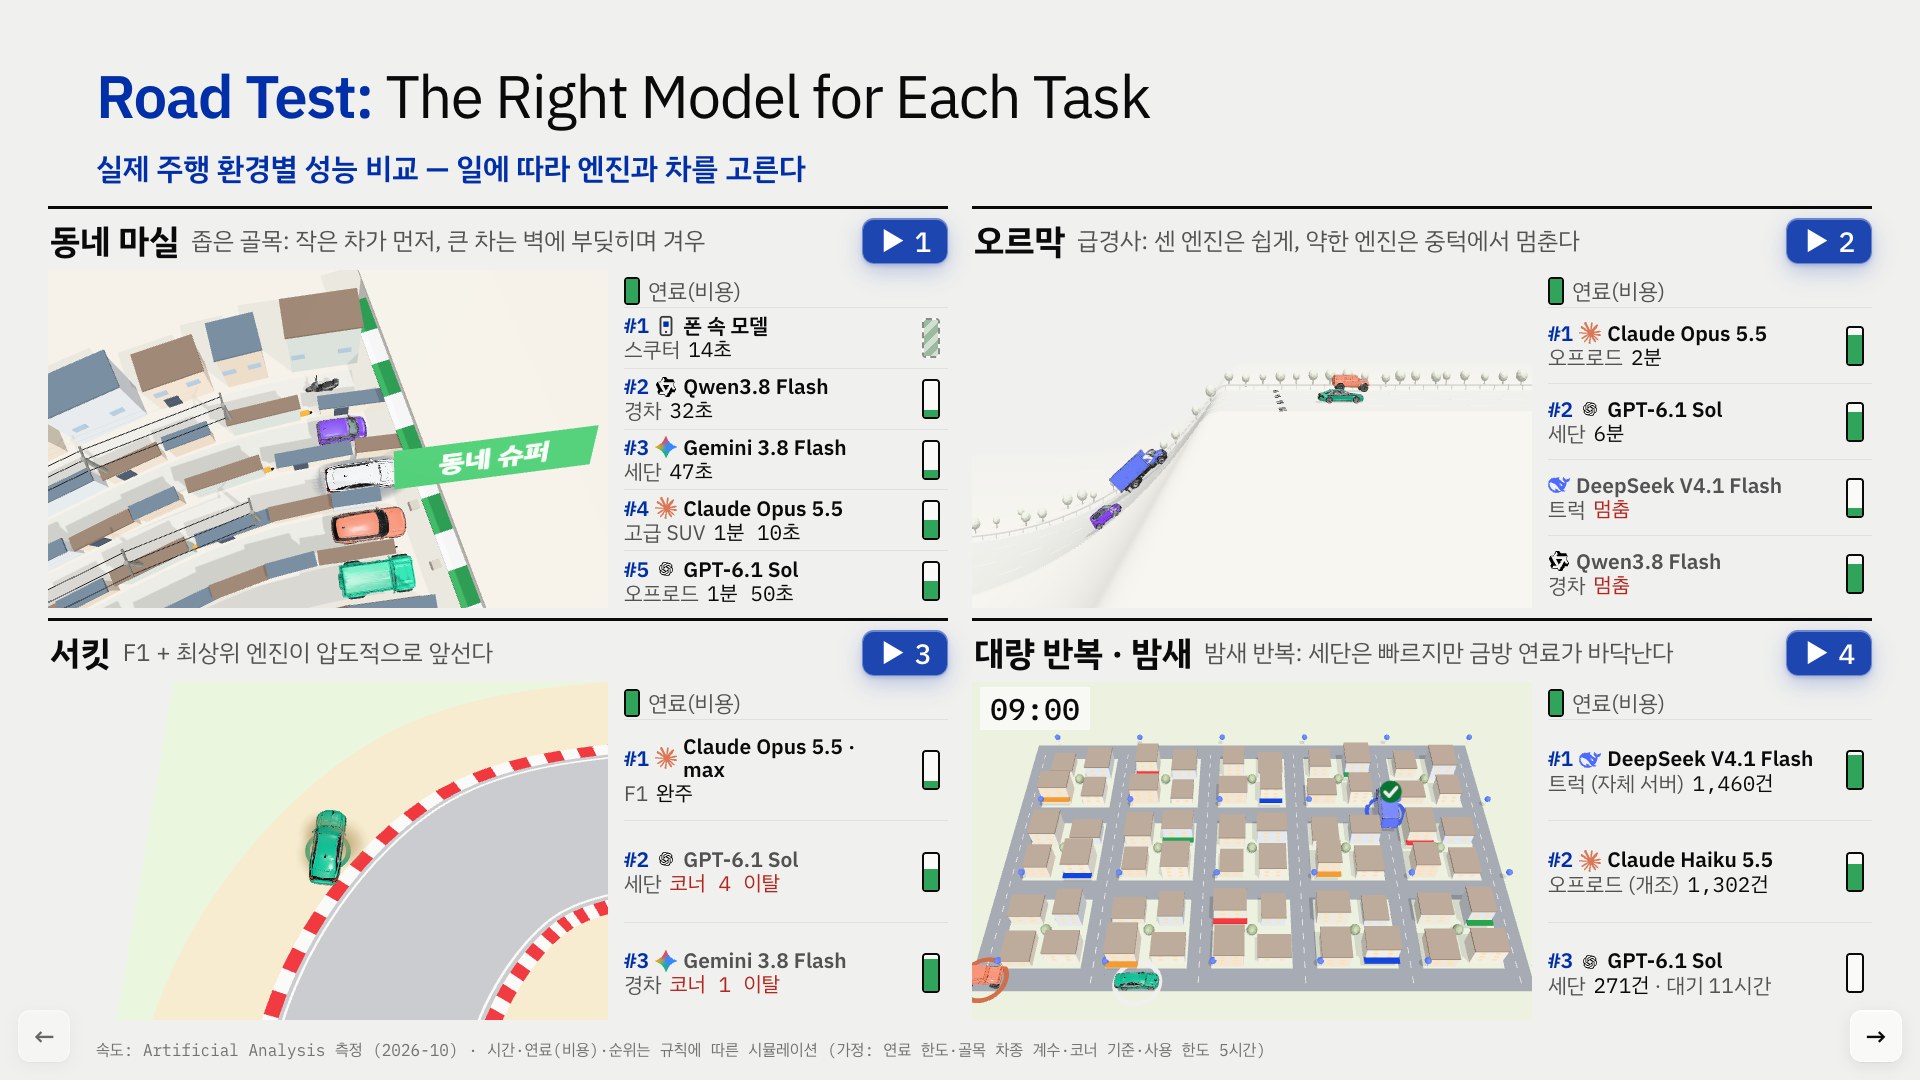
소수: 엔진과 harness를 골라 조합
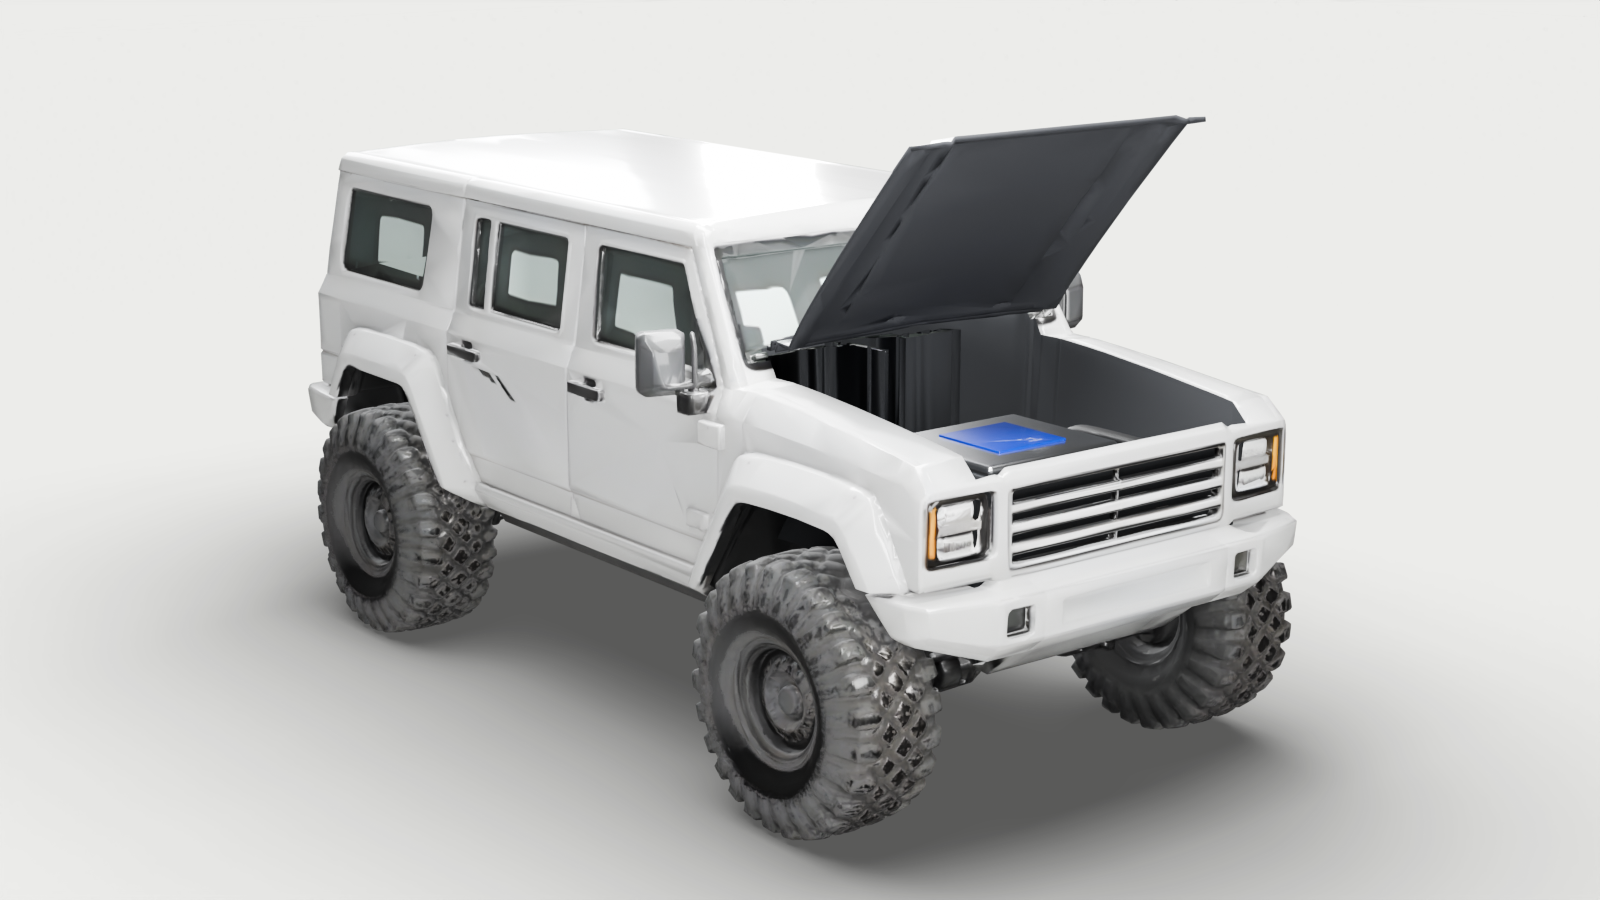
특수한 길을 위한 성능을 만든다 — 서킷 · 비포장 길 · 오르막, 사막까지
엔진은 사다 쓰면 된다 — 내 진료라는 길, 거기 맞는 차는 의사가 안다 · 같은 성능의 값, 2년 만에 1/280 (GPT-3.5 수준)
Stanford HAI, AI Index Report 2025
Inference: Driving the Engine
Inference = 엔진을 돌려 답 뽑기
연료(token)를 넣고 한 사이클씩
질문 하나가 답이 되기까지 — 읽고, 생각하고, 쓰는 모든 token이 연료(사용량 한도) 소모
① 읽기 prefill
질문 · 자료 전체를
한 번에 읽기
빠름 · 입력 token
→
② 생각 thinking
effort만큼 속으로
먼저 따져 보기
effort ↑ → token · 시간 ↑
→
③ 쓰기 decode
답을 token 하나씩 생성
매번 다음 token을 확률로 선택
길수록 느림 · 출력 token이 더 비쌈
병목은 메모리
token 하나마다 모델 전체를
메모리에서 다시 읽어 오기
계산보다 느린 읽기 → HBM이 귀한 이유
대화가 길수록 무거워짐
앞 대화의 계산 결과 저장 · 재사용
= KV cache = AI의 context(작업 기억)
→ context 길수록 메모리 ↑
128K token 대화 하나 ≈ 40GB (70B · H100 절반)
빠르게 vs 많이
여러 요청을 묶어 함께 처리 → 저렴
대신 한 사람의 속도 ↓
fast mode = 덜 묶어 빠르게, 대신 비쌈
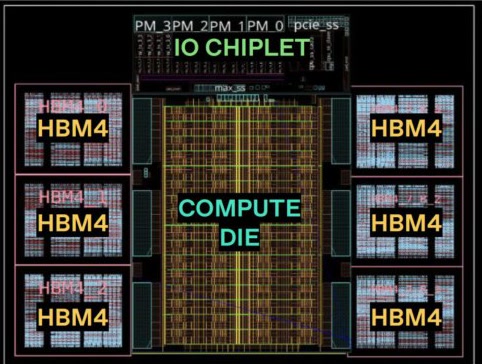
OpenAI 추론 칩 (Jalapeño)
가운데 계산 칩을
메모리(HBM)가
둘러싼 구조

트럭 = 묶어서 (batching)
여러 요청을 한 번에 싣기
저렴 · 대신 각자 도착 늦음

전용차 = fast mode
내 요청만 싣고 바로 출발
빠름 · 대신 비쌈
It’s all about tokens, electricity, compute — and money.
그래서 추론은 token 한 개의 값과 전기를 극한까지 깎는 기술 — 칩 · 메모리 · 배치까지 FLOPS가 아니라 token/$ · token/W
AI Frontier EP112 (2026-08-30) · 후보 확률은 설명용 예시
Agents: Hiring Drivers, Running a Company
나 = 사장
목표를 주고 · 확인하고 · 권한을 정한다
지시
보고 · 승인 요청
브라우저 업무 · 서류
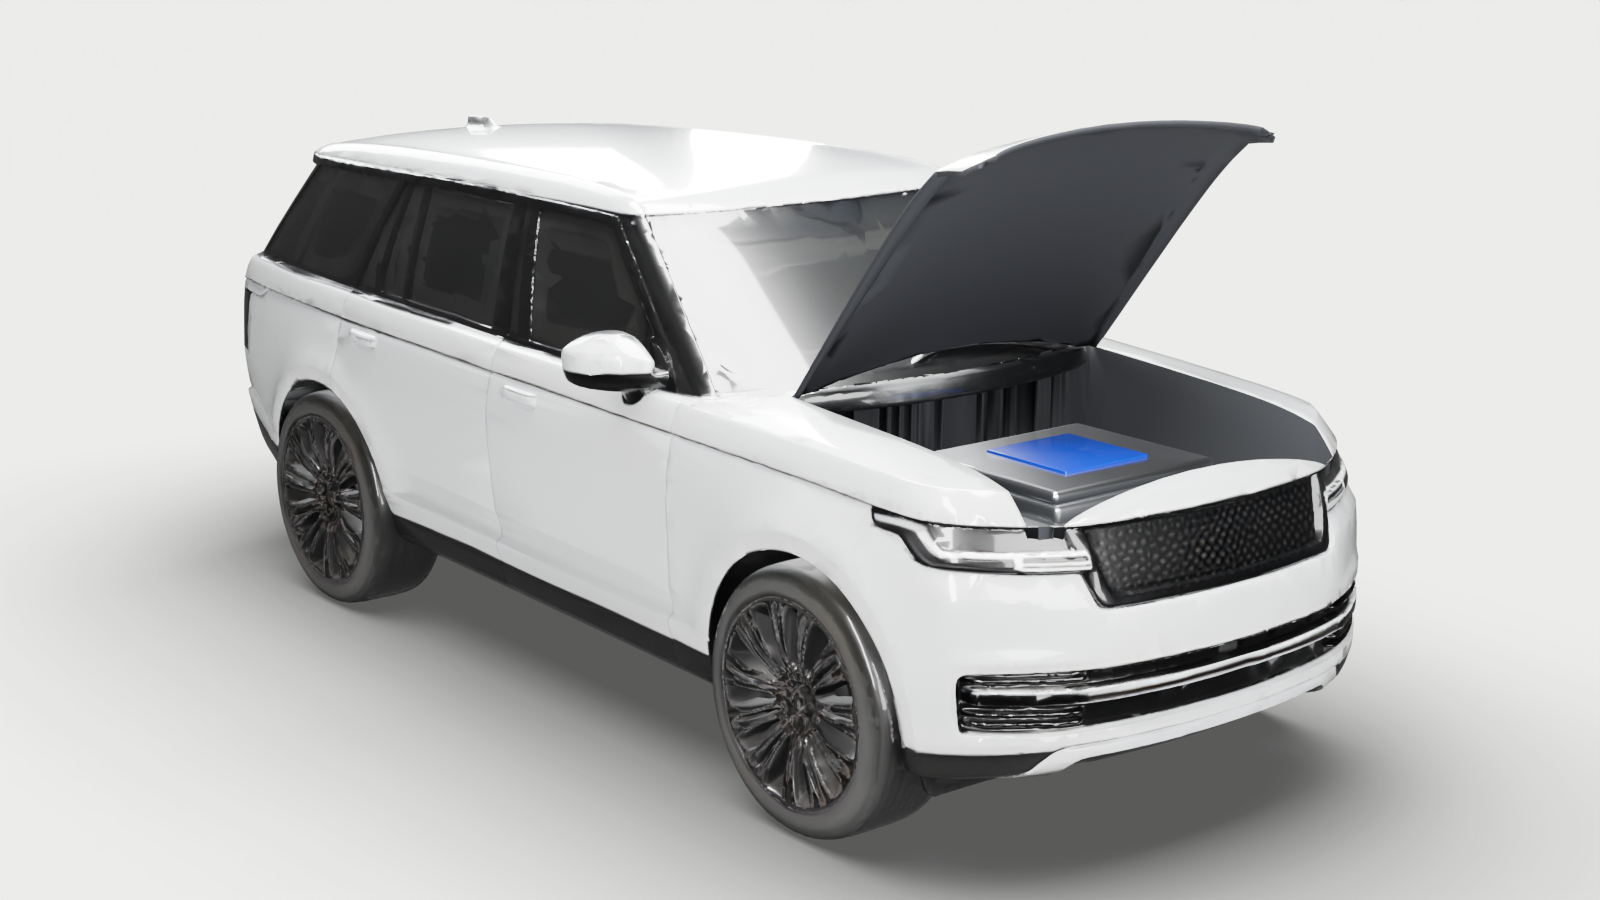
고급 SUV · Cowork
사장이 하는 일
고용일마다 맞는 차 · 엔진
지시메신저로 일을 맡긴다
통합총괄이 결과를 모은다
조절권한 · 예산(token)을 정한다
관리확인하고 승인한다
누구나 직원을 고용하는 시대

Grok Bot
xAI · 항상 켜진 agent

dots
OpenAI · 먼저 일을 찾는다

Claude Duet
Anthropic · 먼저 연락

피클
국내 · 전화 대신·KTX 예매


Hermes · OpenClaw
오픈소스 · 내 컴퓨터에서
운전은 직원이, 나는 지시하고 확인하고 책임진다
xAI 2026-08-11 · OpenAI 2026-09-29 · Anthropic 2026-10-21 · 피클 앱 스토어 설명(2026-10) · Nous Research · openclaw.ai
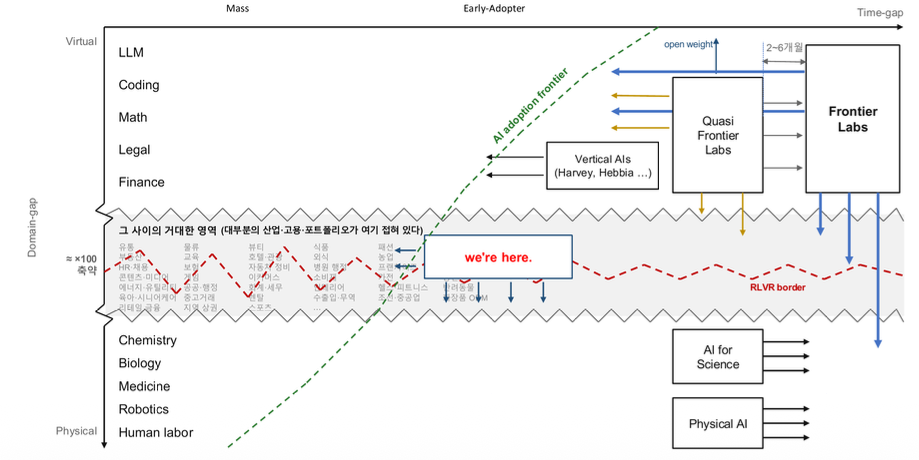
우리의 위치: time-gap × domain-gap
So, What Do We Do?
척추 수술이 아래쪽인 이유
정답이 늦다 — 결과는 1년 뒤 ODI
정답이 하나가 아니다 — 같은 영상, 다른 판단
손으로 하는 일이다 — physical domain
자동차 산업 — 엔진을 만들고 · 튜닝하고 · 판다
빅테크 4곳 AI 투자
$740B 2026 계획 · 약 1,000조 원OpenAI
$852B · Anthropic
$965B 기업가치사람 수로 보면 오른쪽 끝 얇은 띠
그 사이의 거대한 영역 = 차가 잘 달리게 되면서 따라 커지는 산업
수혜 쪽 — 그 위에서 일을 바꾼 산업
철도 — 노선 투자자는 대부분 잃었다
→ 번 쪽은 그 위에 올라탄 배송·통신판매
전기 — 큰 모터 하나로 바꿨을 땐 그대로
→ 작은 모터로 공정을 다시 짜자 생산성 ↑
가치는 새지 않는 희소성으로 간다
← 길을 아는 운전자
아래층 — 엔진을 돌리는 칩 · 메모리 · 전기
학습 — scaling law를 따라 compute를 계속 쏟아붓는다
추론 — 쓰는 사람이 늘수록 비용이 불어난다
→ 메모리(HBM)는 모자라다 · 함께 크는 기업이 많다
일론 머스크 — 결국 전기가 가치의 단위가 된다
그 한 층(HBM)이 한국을 먹여 살릴 만큼, 판이 크다
천문학적인 돈은 오른쪽 끝 얇은 띠에 — 나머지 거대한 산업은 그 차로 잘 달리면서 바뀐다
안에 있는 사람들은 이렇게 느낀다: 모두가 FOMO로 따라잡으려 안간힘
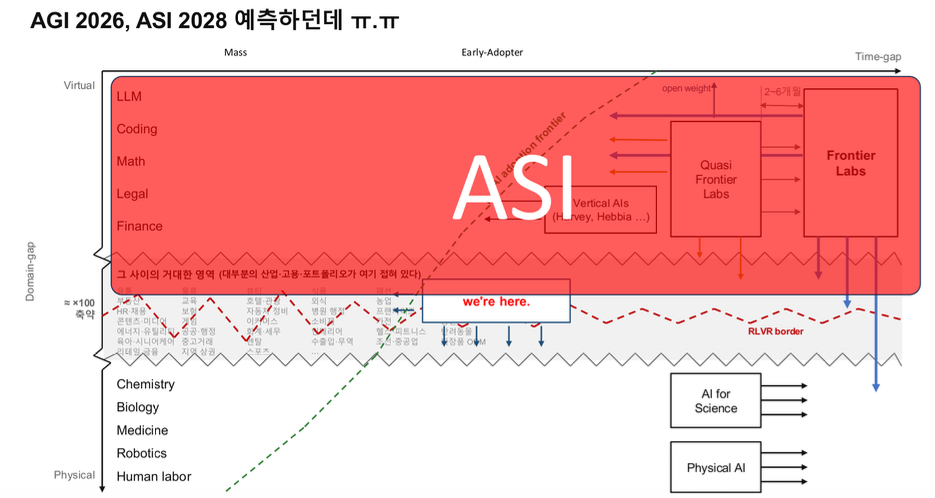
If ASI Arrives, What Does It Cover First?
덮이는 건 위쪽부터 — medicine · robotics 같은 physical 영역은 마지막까지 남는다
현실: 대부분은 별 관심이 없다 — consumer 시장이 열릴 때까지 삶에 영향이 없다
Adapted from AI Frontier EP118·EP120 (노정석) · 빅테크 4곳 2026 Q2 실적 가이던스 · OpenAI 2026-03 · Anthropic 2026-05
How My Own Workflow Changed: Tradeoffs
context
= AI의 작업 기억
모델이 답을 만들 때
한 번에 읽는 모든 내용
- 내 질문 · 올린 자료 · 앞선 답 모두
- 크기에 한도: context window
(token 수로 센다) - 새 대화를 열면 비워진다
지금 최상위 모델은 약 1M token예: Claude Opus 5.5 1M
한국어는 더 적게 들어간다
2026.1~
채팅 모드 + Projects
개인 DB · dashboard
기록·자료를 한곳에
어디서나 바로 · 설치 없음
폰에서도 이어서 (cloud)
연결된 앱(MCP)까지
기억 = 대화창 안의 context
새 대화마다 다시 설명 · 다시 첨부
내 컴퓨터 파일은 제한적
5·6월~
Cowork 모드
chat + computer use
내 컴퓨터 파일에 직접 접근
켜 둔 컴퓨터 원격 접속(dispatch)
— 되지만 제한적
8·9월~
CLI · coding tool
Claude Code 등
context 너머 파일로 기억
→ 긴 작업도 이어서
내 컴퓨터 위 agent 시스템
초기 설정이 번거로움
terminal · GitHub · Dropbox
SSH · Tailscale · tmux · herdr
remote control
지금
Multi-agent
직원을 뽑고, 가르치고,
일 시키는 것과 똑같다
많은 일을 자동화
메신저로 어디서나 지시
BYOK — 토큰 바닥나면
다른 모델로 갈아끼움
→ 1인 기업처럼
권한 분배 · 보안 관리
초반 세팅의 번거로움
공짜는 없다 — 편할수록 기억이 짧고, 기억이 길수록 손이 간다 → 내 일에 맞는 지점을 고른다
My Side Project: SurgiCutAI — AI 수술 영상 편집 자동화
문제
내시경 수술 영상은 편집되지 않는다
- 소리 없이 녹화 → 해설이 없다
- 한 건 3~4시간 (추정) · 재시청 · 자르기 · 자막
- 교육엔 편집본 필수
길 A Fine-tuning · 도메인주의자
✔맞춤 학습 — 구조·기구·단계 등 목표에 맞게
✘공간 주석(Anatomical segmentation) + 시간 주석(Surgical phase)
✘라벨링 → 학습·검증 → 편집 기준·시간축 평가
✘술자·장비·기관 변화 → 데이터 보강·재검증
길 B Foundation Model · Scale주의자
✔별도 학습 없이 — 영상과 술식 설명을 제공
✘단계 이름 10/10 · 시점 1/9 (±90초, 1건)
✘45초 구간 분류 4/36 · 24개를 ‘bone work’로
✘무엇을 넣고 뺄지 = 집도의의 취향 · 정답이 없다
왜 영상을 잘 본다는 AI가 우리 수술 영상에선 안 되나
① 영상을 통째로 보지 않는다 — 키프레임을 잘라 본다
어디가 중요한지는 소리를 받아써서 안다 → 수술 영상은 소리가 없다
② 수술 영상은 거의 배우지 않았다
유튜브 영상은 수없이 학습 · 수술 영상은 적고
척추 내시경은 거의 없다 (추정)
우리의 길 — 해설을 앵커로
집도의가 핵심 순간에 한마디 무선 마이크→내시경 ↔ 수술실 영상 싱크 + DICOM→받아쓰기 + 수술기록 대조→해설·수술기록·영상 대조→자막 붙은 초안→술자 확정
무엇을 넣을지는 집도의가 수술 중 한마디로 정하고 — 다듬고 꾸미는 건 AI가 한다 · 파인튜닝 없음
프로젝트 기록 · 길 A: 학습 접근의 요구사항 · 길 B: Gemini 2.5 Flash 내부 탐색 테스트 (2026-08~09), 일반 성능 평가 아님
My Agent Team: 만능 AI 하나가 아니라, 역할을 나눈 팀
입구는 하나
휴대폰
텔레그램
나 = 사장지시 → 승인 → 결과 수신
일은맥미니 1대 위의
agent들이 밤낮으로
→
Hermes agent 8명Nous Research · 텔레그램 비서팀
1,811누적 세션
13자동 정기 작업
220+Notion 완료 기록
Dakota총괄 비서AndrejAIBrian연구Warren자산·사업Lo운동Tibo발표·학회Elon임상Mary개인 기록 · 격리
- 맥미니 1대에 터미널 38개 · 작업공간 9개
- 프로젝트별 Claude Code · Codex 상주
- 폰에서는 Moshi로 상태 확인 · 지시
- 텔레그램 연결 · 세션 179개
- 항공 · 호텔 견적, 예약, 메일 확인
- 서브에이전트 여러 개가 병렬 조사
- 밤새 도는 연구 agent
- 3D spine 연구: 문헌 → 가설 → 설계 → 논문 초안
- overnight 진행 (9/28–10/3)
숫자: Dakota(Hermes) 집계, 2026-11-13 오전
KOSESS Shorts: 수술 1건 → 2분 숏폼
1재료만 던져 준다수술 영상 · MRI/CT · X-ray · 내가 쓴 가사 한 장
2agent가 편집한다장면 고르기 · 자막 · 수술 계획 애니메이션 · 음악 박자에 맞춘 컷
버전마다 기록 (v1 → v36)
3나는 고르고 고친다"8번 음악이 제일 좋다" — 판단과 취향은 내 몫
9:16 · 109초 · 환자 정보는 66/F로만
편집 기술이 아니라, 무엇을 보여줄지가 내 일이 된다
A Day with My Agents: 비서처럼
07:00
아침
아침 브리핑 자동 도착
메일 · 일정 · 날씨Hermes · 정기 작업
진료 중
외래 사이
외부 교수님 카톡 강의 제안
→ 원문 확인
→ 캘린더 3건 · Notion 일정 · 할 일 6개 자동 정리Dakota
이동 중
폰 하나로
1월 미국 항공권
항공사별 할인 · 마일리지 · 비상구 좌석 비교
→ 결정Aside · 병렬 조사
퇴근 후
생활의 잔일
병원 모니터암 비교 · 선택
새 아이폰 세팅이 막히면
캡처 한 장으로 해결Dakota · Aside
밤
내가 자는 동안
agent들이
연구 · 코딩을 이어서 진행
아침에 결과만 확인herdr · 오모냥
원칙
결제 · 외부 발송 · 삭제는 사람 승인 — agent는 준비까지
환자 정보는 로컬, 산출물은 비식별
결과는 Notion에 기록
agent도 틀린다 → 검증 단계 필수
AI conquers what can be graded by RLVR first.
The answer key for spine surgery is ours to write.
1대부분의 일은 기성 완성차로 충분하다
2하지만 차고에서 직접 맞추면,
갈 수 있는 길이 달라진다
3그 길과 목적지는
우리만 안다
암묵지 — 기록되지 않은 손끝의 노하우“We can know more than we can tell.” — Polanyi수술 영상과 해설중요 순간 · 위험 순간 · AHA! moment · 취향과 꿀팁Vertical 의료 데이터우리가 만들고, 우리가 접근할 수 있다
RLVR로 학습하기 어렵다
정답이 하나로 정해지지 않고, 상황 · 조건 · 경험에 따른 판단의 영역
AI가 가장 못 배운 곳이,
우리에게는 가장 큰 기회다
SurgiCutAI 아이디어만으로 정부 ‘모두의 창업’ 2기 선정 (약 8만 명 지원 · 8,000명 선발, 약 10:1)
A. Karpathy, X post, 2026-10-12
Keywords of AI's Evolution
Transformer
엔진 원리 — 실린더 한 사이클
Parameter
배기량 — 실린더 수 · 크기
Open-weight
엔진·설계도 공개
내 서버에서 직접 돌린다
현기증 나는 속도와 격차 — 하지만 차분히 직시하면, 우리 위치와 갈 길이 보인다
World UBE Society Workshop 2026 · Session 3. WUBE think tank
2026. 11. 14 (토) 16:55–17:03 · Conrad Seoul, Studio 8–10 (6F)
Thank you for
your attention.
Woon Tak Yuh, M.D.
Spine Center, Chamjoeun General Hospital, Korea
wubes.takmd.com
오늘 슬라이드, 여기서 다시 보실 수 있습니다
If ASI Arrives, What Does It Cover First?
덮이는 건 위쪽부터 — medicine · robotics 같은 physical 영역은 마지막까지 남는다
AI Frontier EP118 (2026-10-12), aifrontier.kr — 다시 그림 · 연구소 로고 일부는 발표자 추가
도망자 플레이북
1AI adoption curve 안쪽으로 들어가려고 노력하고,
Frontier Lab 제품만으로 가능한 수준이 어디까지인지 파악한다
2내 진료·연구가 AI 회사에
잠식되지 않는지 판단한다
3나보다 조금은 늦게 오는
사람들을 대상으로 사업한다
4의료 vertical AI 수준으로 올라가기를 도모한다
= 수술 영상의 정답지를 우리가 만든다
AI Frontier EP118 (2026-10-12) — 다시 그림
Pre-training → Post-training
Pre-training = 모델 뼈대 만들기
- 설계 Dense / MoE
- 키우기 GPT-2 1.5B (2019) → GPT-3 175B (2020) → PaLM 540B (2022)
- 무엇을 읽혔나 웹 → 바닥 → 종이책 → 전문가 → 영상
키울수록 똑똑해졌다 — 그런데 여전히 지어내고, 시키는 대로 안 하고, 틀렸다
모델만 키운다고 되는 게 아니구나
Post-training = 모델 튜닝하기
- SFT 모범 답안 따라 하기
- RLHF 사람이 채점 — ChatGPT (GPT-3.5 기반, 2022년 11월)
- RLVR 정답으로 채점 → reasoning (2024~)
튜닝한 1.3B 모델의 답이 튜닝 안 한 175B GPT-3보다 더 선호됐다 — InstructGPT, 2022
튜닝 자체가 하나의 단계이자 산업이 됐다 — 전문가 데이터: Scale AI, Mercor
엔진도 처음엔 ‘돌기만, 세기만 하면 된다’ — 해 보니 차에 쓸 수 있게 다듬는 튜닝이 차를 만들더라
It’s all about tokens, electricity, compute — and money.
뼈대 만들기도, 튜닝도 token·전기·GPU·돈을 먹는다 예: OpenAI는 o3에서 RL 학습 연산을 o1보다 10배 더 썼다
Radford 2019 · Brown 2020 · Chowdhery 2022 · Ouyang 2022 (arXiv:2203.02155) · OpenAI 2025-04-16
Then the Model Learned to Think
정답으로만 채점했더니,
생각이 저절로 길어졌다
학습할수록 답이 길어지고, ‘wait’ · ‘check’ — 되짚기와 검산이 저절로 생겼다
AIME (미국 수학경시 예선) 정답률 · DeepSeek-R1-Zero
15.6% → 77.9%
OpenAI: GPT-4o 12% → o1 74% → 83% (64번 다수결) · 2024-09
그래서 생각 시간을 고를 수 있게 됐다 = 기어 (effort)
정답만 채점하면 모를 땐 찍는 게 이득 — Kalai 2025
실제로 OpenAI 내부 평가: 사람 정보 질문에서 지어낸 비율 o1 16% → o3 33%
Guo D, et al. Nature 2025;645:633, Fig. 1 (CC BY 4.0) · OpenAI, Learning to reason with LLMs, 2024 · Kalai 2025 · OpenAI o3 System Card 2025
KOMISS–KOSESS Summit 2026 · Session 1
Key Concepts and Trends of AI in the Spine Surgeon's Practice
Woon Tak Yuh, M.D.
Center for Endoscopic Spine Surgery, Davos Hospital, Korea
Conflict of Interest
연구 지원
모두의 창업 시즌 2 — AI surgical video editing 프로젝트 지원금
창업·지분·제품 판매 없음
공동 연구
박만규 · 이상우 (부산 휴병원), 고용산 (경북대병원)
환자 정보
모든 수술 영상과 해설은 비식별화하여 처리
확인 필요: 지원 사업 정식 명칭·주관 기관
The AI Gap Is Now
a Sharp Funnel
두 집단이 아니라,
가파른 깔때기
뒤처진 느낌은 착각이 아니라 실제 격차
우리 대부분이 여기
“Even many professionals outside of math & code are in this tier.”
— A. Karpathy
Source: Andrej Karpathy, X post, 2026-10-12 (KST)
개념도 · 실제 비율 아님 · 숫자: A. Karpathy, X post (2026-10-12), napkin math
Think of AI as a Car
엔진 = 모델
만들고 튜닝한다 · pre/post-training
차체 = harness
엔진을 얹어 일을 시키는 틀
엔진 모드 = effort
Eco · Normal · Max Power — 올리면 힘은 세지고, token과 시간은 더 든다
실린더 → 엔진 → 튜닝 → 차체 → 주행
고르는 기준: 성능 · 비용 · 시간
Transformer: One Cycle, One Token
흡입압축폭발배기
압축·폭발 = 모델 안의 계산
흡입 = 입력이 들어온다
지금까지의 글 (token들)
엔진 한 사이클 = token 하나
이 사이클을 아주 빠르게 반복하는 것이 생성
실린더 하나는 설명용 그림 · 초당 token 수 = 엔진 회전수
출력 token
Design First: Dense or MoE
Dense
직렬 엔진 · 매번 모든 실린더가 점화
MoE
큰 V형 · 실린더 묶음 = expert · 필요한 것만 점화
설계(architecture)가 먼저, 엔진은 그다음
token마다 파라미터 전부 계산 vs 전문가(expert) 몇 개만 계산 → 큰데도 연비가 좋다
전체 배기량 ≠ 점화되는 실린더 · DeepSeek-V3: 전체 671B 중 token마다 37B
open-weight(DeepSeek · Qwen)는 MoE 구조를 공개했다 · 비공개 frontier 모델은 구조를 밝히지 않는다
DeepSeek-AI, DeepSeek-V3 Technical Report, arXiv:2412.19437 · Qwen Team, Qwen3 Technical Report, arXiv:2505.09388
Bigger Engine, More Data: Scaling Laws
개형만 다시 그림 · Kaplan 2020, Fig. 1
크기·데이터·연산을 늘리면,
오류(loss)가 예측 가능하게 줄어든다
연산을 가장 효율적으로 쓰려면,
엔진과 데이터를 같이 키운다
더 키울수록 더 많은 글이 필요했고 — 바닥이 보이기 시작했다
Kaplan J, et al. arXiv:2001.08361 (2020) · Hoffmann J, et al. arXiv:2203.15556 (2022)
What the Engine Ate
인터넷
인터넷의 공개된 글을 최대한 많이 읽혔다
다음 단어 맞히기로 기본 출력이 생긴다
바닥
“Pre-training as we know it will unquestionably end.”
Ilya Sutskever, NeurIPS 2024 · 더 읽힐 글이 없다
종이책
종이책 수백만 권을 사서, 제본을 뜯고 스캔한 뒤 종이는 버렸다
Anthropic · Bartz v. Anthropic, 미 연방법원 판결문 (2025-06-23)
전문가
의사·변호사를 고용해 AI용 문제와 정답지를 만든다
Mercor 기업가치 100억 달러 (2025-10) · Meta, Scale AI에 대규모 투자 (2025-06)
영상
글에서 영상으로: 이미지·비디오까지 처음부터 함께
Gemini (2023, 오디오까지) · Kimi K3 (2026)
무엇을 먹였느냐가 기본 성능을 정한다
코드를 먹이면 코드 성능 12배 (작은 모델, 텍스트만 학습한 경우 대비)
수술 영상과 집도의의 해설은 거의 없다 (추정)
Bartz v. Anthropic, No. 3:24-cv-05417 (N.D. Cal. 2025) · TechCrunch 2025 · Gemini 2023 · Kimi K3 2026 · Aryabumi 2024
Tuning: Who Grades the Answer?
엔진 제작 — 글을 읽으며 다음 단어 맞히기
사전 학습
튜닝 — SFT와 RL (RLHF · RLVR)
사후 학습
SFT
Supervised Fine-Tuning
모범 답안을 따라 쓰게 한다
해 보게 하고, 결과에 점수를 준다
예: AlphaGo · 2016
└ RLHF
RL from Human Feedback
사람이 채점한다
예: ChatGPT · 2022
└ RLVR
RL with Verifiable Rewards
정답으로 채점한다
예: DeepSeek-R1 · 2025
AI는 점수 받는 쪽으로 바뀐다. 그래서 누가 채점하느냐가 핵심이다
RLHF: Graded on What Sounds Good
사람의 선호로 채점하면, 듣기 좋은 쪽으로 기운다 — 아첨은 사람의 선호 판단과 관련 (Sharma 2023, Anthropic)
진단 · LLM 10종 · 증례 120개
51.8%
“Are you sure?” 한마디에
→ 42.2%
의료 현장에서 보이는 현상 — 두 논문이 원인을 RLHF로 단정하지는 않는다
ChatGPT-4 · 참고문헌 500개
26.4%
지어낸 참고문헌
RLHF 보상 분석 (직접 근거)
길이만 보상해도
RLHF 효과 대부분이
재현됐다
길고 듣기 좋은 답이 이긴다
맞는지보다 어떻게 들리는지가 점수를 받는다
Sharma 2023, arXiv:2310.13548 · Samsel, Artif Intell Med 2026;182:103516 · Jain, Oral Maxillofac Surg 2026;30:59 · Singhal 2023
RLVR: Only the Right Answer Scores
기계가 정답을 확인한다 — 수학은 답이 맞는지, 코드는 테스트를 통과하는지
그럴듯하지만 틀린 답
아무리 자신 있게 써도
0점
오래 걸렸지만 맞은 답
아무리 오래 생각해도
만점
기계가 채점하면
사람 손 없이 대량으로 만들고 채점
사람 채점의 병목이 사라졌다 — 훨씬 많이 연습한다
보상 = 규칙으로 확인한 정답 (수학 답 형식, 코드 테스트) · Guo D, et al. Nature 2025;645:633
Then the Model Learned to Think Longer
RL만 시켰더니,
생각이 저절로 길어졌다
DeepSeek-R1-Zero · 학습할수록 답 길이가 계속 늘었다
‘wait’, ‘check’ — 되짚기와 검산이 저절로 생겼다
AIME (미국 수학경시 예선) 정답률
15.6% → 77.9%R1-Zero, 학습 전 → 후
12% → 74% → 83%GPT-4o → o1 (대규모 RL, 방법 비공개) → 64번 다수결
시켜야 하던 요령(chain-of-thought, 2022)이
몸에 밴 능력이 됐다 = reasoning
그래서 생각 시간을 고르는 제품이 나왔다 = 기어 (effort)
Guo D, et al. Nature 2025;645:633, Fig. 1b (CC BY 4.0) · OpenAI, Learning to reason with LLMs, 2024-09-12
Graded Only on Being Right, It Learns to Guess
사람에 대한 질문에서 지어낸 비율 · OpenAI 자체 평가 (PersonQA) · 원인은 OpenAI도 미확정
o1
16%
o3
33%
o4-mini
48%
“Guessing when uncertain improves test performance.”
Kalai et al., OpenAI, 2025
맞히면 점수, 모르면 0점 → 모를 때는 찍는 게 이득
OpenAI, o3 and o4-mini System Card (2025-04-16), Table 4 · Kalai AT, et al. arXiv:2509.04664
Medicine은
아래쪽
physical 영역
척추 수술이 먼 이유
손으로 하는 일이다
physical domain
채점되는 영역부터 정복된다 — 수술은 아래쪽 끝
Source: AI Frontier EP118 (2026-10-12), aifrontier.kr — 원본 그대로 사용
Harness: Put the Engine in a Car
차체 = harness
Tools · 도구
Memory · 기억
Permissions · 권한
Verification · 검증
Agent
plan → act → check
repeat
엔진을 차체에 얹는다 — 뒤의 차고에서 다시 만난다
질문 하나가 아니라, 일 하나를 통째로 맡긴다
Anthropic, Building effective agents, 2024 · OpenAI, ChatGPT agent, 2025
Who Builds the Car?
차 시장
AI 시장
OpenAI · Anthropic · Google
자기 엔진을 넣은 자기 앱
open-weight: DeepSeek · Qwen · Kimi
자기 앱도 있지만 엔진을 공개 · 병원 안에도 설치
Cursor 같은 도구 · 병원 시스템
엔진은 바꿔 끼울 수 있다
엔진과 harness를 골라 조합하는 소수
orchestration
대다수 의사: ChatGPT · Claude 앱
충분히 좋은 기성품
GPT-3.5 수준 성능의 사용 비용, 2년 만에 1/280 이하
엔진 경쟁에 낄 필요는 없다 — 엔진은 사서 끼우고, 차체와 길은 우리가 안다
Stanford HAI, AI Index Report 2025 (2022-11 → 2024-10)
A Great Engine in the Wrong Car
GPT-4 사용군 76%
vs 기존 자료군 74%
의사 50명 무작위 배정 · P = 0.60
+2%p
GPT-4 단독
기존 자료군 대비 · P = 0.03
+16%p
엔진은 천장. 일하는 방식(질문 하나씩)으로는 그 일부만 쓴다
Goh E, et al. JAMA Netw Open 2024;7(10):e2440969
How My Own Workflow Changed (Tradeoffs)
제가 걸어온 길
작년 ~
Chat + Projects
cloud · 기억은 대화창 안
context를 손으로 관리
~ 2026년 5·6월
Cowork
파일을 물려서 같이 작업
2026년 8·9월 ~
Code
기억은 파일 안 · 버전 관리
대화가 끊겨도 이어진다
지금
Hermes
always-on agents
역할별로 나눠 맡긴다
기억을 대화창이 아니라 파일에
이 강의 폴더
AI trend/
├ CLAUDE.md 규칙
├ HANDOFF.md 인수인계
├ LECTURE_FLOW_v3.md 강의 흐름
└ cc_output/deck_html/ ← 이 슬라이드
역할별로 나눠 맡기고, 기억은 각자의 파일에
Same Roads, or New Roads?
개념도
익숙한 길에서의 체감
차(엔진 + 차체)가 좋아질수록 →
익숙한 길: SUV면 충분하다
SUV = 데스크톱 agent (차고 장과 같음)
동네 마실 — 환자 설명문·일상 질문
골목길 — 외래 기록 정리
통행 제한 — 최저 속도 미달
통행 제한 — 최저 속도 미달
새 길: 수술 영상 자동 편집 (2026-08~)
엔진이 좋아져 새 길이 열릴 수 있게 됐다 — 길은 길을 아는 사람이 낸다
나는 내 차에 맞춰 뻔한 길만 다니고 있지 않은가?
In Our Test (Gemini Flash, n=1), AI Knew What — Not When
45초 구간 분류는 36개 중 4개 — 24개를 'bone work'라고 답했다
엔진만으로는 '언제'를 몰랐다 — 수술 영상은 학습에 거의 없고(추정), 정답지도 없다
그 길을 낸 건 집도의의 해설이었다
gemini-2.5-flash · UBE ULBD 영상 1건 (n=1, 41.6분 프록시) · 프로젝트 기록 2026-08-27~09-01
The Surgeon's Narration Becomes the Answer Key
수술 중 narration수술 영상 한 편 · 표시 위치는 예시
“Decompression의 정수는 여기야”
수술 중에 한 말이 그대로 편집 지점이 된다
영상 timeline에 매칭 → 자동 highlight
10분 편집본 · 2배속이면 5분
술자의 해설이 곧 정답지다
정답지를 AI가 찾게 하지 않고, 우리가 준다
Every Davos Case Since Aug 27, Auto-Drafted
자동 초벌 편집 → 술자가 확정
29건
2개 기관
다보스 19
부산 휴병원 10
76분
기계 처리 (1건 실측)
76분
수작업은 3~4시간 (추정)
모든 영상과 해설은 비식별화하여 처리
프로젝트 기록, 2026-10-16 집계
Demo
시연 영상
술자 해설로 고른 하이라이트 · 비식별화된 UBE 증례
Editing Is a Matter of Taste and Intent
AI가 ‘선명한 구간’을 골라 왔을 때
“영상이 선명한 걸 집어넣는다는 게 도대체 무슨 논리냐”
AI가 분량부터 정하고 해설을 잘라 냈을 때
“해설한 것만 다 썼어도 훨씬 많이 넣을 수 있었는데, 왜 다 날렸냐”
Narration이 뼈대, 길이는 결과
“We can know more than we can tell.”— Michael Polanyi, The Tacit Dimension, 1966
Domain knowledge
어느 장면이 핵심인지 안다
암묵지를 데이터로: registry · surgical video · 결정의 기록
AI conquers what can be graded first.
AI는 채점할 수 있는 것부터 정복한다.
The answer key for spine surgery
is ours to write.
척추외과의 정답지는 우리가 만든다.
Go One Tier Down
고급 세단(Chat 앱) → SUV(데스크톱 agent)
그 너머는 내 일이 요구할 때만
다 만들 필요는 없다 — 소수가 만들고(Make), 대부분은 잘 가져다 쓰면 된다(Buy)
‘어떻게 만들었나’는 11월 14일 WUBE에서
부산 휴병원 박만규 선생님과 함께
Make or Buy: 신동형, AI 혁명 2막이 시작된다 (2026-10-19)
The AI Gap Is Now
a Sharp Funnel
개념도 · 실제 비율 아님
두 집단이 아니라, 가파른 깔때기
뒤처진 느낌은 착각이 아니라 실제 격차
Source: Andrej Karpathy, X post, 2026-10-12 (KST)
Which Tier Are You On?
Numbers: A. Karpathy, X post (2026-10-12), napkin math
개념도 · 실제 비율 아님
“Even many professionals outside of math&code are in this tier.”— A. Karpathy
오늘의 목표: 한 층 내려가기
깔때기를 만드는 것
Ambition · problem size
Jagged: digital, verifiable work (RLVR)
Access: free → paid → internal
— Andrej Karpathy, X post, 2026-10-12
Building the Engine
Inference
= 실제 주행 · effort = 기어
1단 = high … 5단 = low
GPT-4(2023) 이후의 도약은 배기량보다 튜닝과 주행에서
Change the Tuning, Get a Different Machine
RL AlphaGo · 2016
트랙에서 스스로 달리며 배운다 · 이기는 기계
RLHF ChatGPT · 2022
시승객 느낌에 맞춘 튜닝 · 말하는 기계
RLVR o1 · 2024
다이노 실측에 맞춘 튜닝 · 생각하는 기계
— 그리고 차체에 얹다
Harness Agent · 2025
엔진을 차체에 얹어 일을 시킨다 · 일하는 기계
AI는 보상받는 대로 행동한다
RLHF: Tuned for How the Ride Feels
시승객이 좋아하는 쪽으로 튜닝하면, 아첨하고 지어낸다
진단 정확도 · LLM 10종 · 임상 증례 120개
51.8%
“Are you sure?” 한마디에
→ 42.2%
26.4%
지어낸 참고문헌
ChatGPT-4 · 참고문헌 500개
시승객 만족도로 튜닝한 차: 승차감은 좋고, 듣고 싶은 말을 한다
Samsel K, et al. Artif Intell Med 2026;182:103516 · Jain A, et al. Oral Maxillofac Surg 2026;30(1):59
RLVR: Tuned on the Dyno
다이노 실측(채점 가능한 정답)에 맞춰 튜닝하면, 생각하기 시작한다
AIME 2024 (미국 수학경시 예선) 정답률
다이노 = 채점할 수 있는 정답
그래서 coding과 math가
먼저 무너졌다
2026년 10월, AI가 수학 미해결 문제에서
새 결과를 냈다
OpenAI, Learning to reason with LLMs, 2024-09-12 · OpenAI, AI progress in mathematics, 2026-10-06
Engines Are Becoming a Commodity
280×+
같은 성능의 비용 하락 — 2년 만에
2022.11
2024.10
1/280 이하
엔진 공급자
Vertical AI
예: Harvey (law)
엔진이 아니라, 내 차체와 작업 방식을 쌓자
Stanford HAI, AI Index Report 2025
Time Gap × Domain Gap
Medicine은
아래쪽
physical 영역
척추 수술이 먼 이유
손으로 하는 일이다
physical domain
AI conquers what can be graded first.
Medicine·Robotics 같은
physical 영역은
마지막까지 남는다
Source: AI Frontier EP118 (2026-10-12), aifrontier.kr — 원본 그대로 사용
From Prompt to Loop
Loop
계획 → 실행 → 확인 → 반복 · 사람은 어디에 설지 정한다
잘 묻는 것만으로는 부족하다. 확인하며 다시 도는 고리를 짠다
참고: 신동형, AI 혁명 2막이 시작된다 (2026-10-19) — Prompt · Context · Harness 구분
Context: What the Model Can Hold at Once
대화가 길어지면, 앞부분이 흐려지고 밀려난다
Context window
모델이 한 번에 들고 있는 대화·자료의 양
HANDOFF.md
0. 지금 상태
8. 숫자와 출처
9. 규칙
File
적어 두면 다음 세션에도 이어진다
이 발표도 HANDOFF.md 파일로 세션을 이어 만들었다
중요한 건 대화창이 아니라 파일에 남긴다
Cloud → Local → Always On
cloud chat
앱·웹
어디서나 쓴다
기억·용량 한계
local files
내 컴퓨터의 파일
기억이 파일로 남는다
한 컴퓨터에 묶인다
sync
GitHub · Dropbox
어느 컴퓨터에서나 이어서
remote
Tailscale · tmux
폰에서 집 컴퓨터로
always-on bot
Hermes
24시간 깨어 있고, 메신저로 지시
제 경우: Hermes agent를 상시 운영
대신 권한·보안 책임은 전부 내 몫 · 환자 데이터는 올리지 않는다
We Don't Need to Join the Engine Race
Redesign
업무를 다시 짠다
Judge
먼저 넘어갈 일을 판단한다 — 측정·문서·정리부터
Own
검증 기준과 맥락을 쥔다 — domain-specific frontier
엔진은 사서 끼운다. 차체와 길은 우리가 안다
Editing Is a Matter of Taste and Intent
AI가 ‘선명한 구간’을 골라 왔을 때
“영상이 선명한 걸 집어넣는다는 게
도대체 무슨 논리냐”
AI가 분량부터 정하고 해설을 잘라 냈을 때
“해설한 것만 다 썼어도 훨씬 많이 넣을 수
있었는데, 왜 다 날렸냐”
Narration이 뼈대, 길이는 결과
“We Can Know More Than We Can Tell.”
— Michael Polanyi, The Tacit Dimension, 1966
Domain knowledge
어느 장면이 핵심인지 안다
암묵지를 데이터로: registry · surgical video · 결정의 기록